雙重差分法
| 內容分類 | 學習筆記 |
|---|---|
| 筆記系列 | 統計學 |
| 筆記篇幅 | 長篇筆記 |
| 學習狀態 | 持續整理 |
| 本篇主題 | 雙重差分 |
先算兩組各自的前後變化,再把變化拿來相減。從職業訓練開始,理解 DiD 怎麼估計介入效果,以及為什麼需要平行趨勢假設。
說實話,這個方法其實在我平常接觸的 Computer Science 研究裡,是相對少見的。
今天會寫這篇,還是因為我剛好有涉獵相關方面的知識,因此來介紹一下這個有趣的方法,也就是 雙重差分法(Difference-in-Differences,DiD)。
它通常出現在經濟學、政策評估等研究裡。但我們 CS 領域也可以用到的原因,其實很簡單,就是這套方法在因果推論(Causal Inference)裡,也是一個重要的 method。
我覺得,在正式介紹它之前,還是得先說明一下:為什麼這類方法,會比較常出現在社會科學的研究裡?
一、為什麼社會科學會需要它?
社會科學研究的核心對象,往往是「人」、「社群」與「制度」。在這些研究裡,有兩件事情通常很難做到。
1. 無法精準控制變數
你無法像在實驗室調控 CPU 頻率,或是調整輸入參數一樣,去控制一個人的生活背景、收入、心理狀態,或是社會關係。
而且,各種可能影響結果的因素,幾乎無處不在。
例如,我們想評估「提高最低工資對就業的影響」。某個城市實施政策後,就業率下降了,但你很難直接區分,這到底是政策本身造成的,還是剛好遇到經濟衰退、產業轉型,或是人口外移。
對,研究對象沒有義務乖乖待在那裡,只讓你想研究的變數發生變化。
2. 無法隨意進行隨機實驗
另一個問題,就是倫理與現實上的限制。
例如,為了研究「失業救濟金對再就業的影響」,研究者不能只為了實驗,就隨機指定一半原本有資格領取的失業人口「不准領救濟金」。
政府推出一項新政策,例如全縣實施免費幼兒園,也可能是全面性的。研究者沒有辦法只為了比較,就強制要求某些家庭被排除在外。
所以,很多時候,我們沒辦法像調整程式參數一樣,把條件安排好,再等結果出來。
但我想,大家應該也看出來了:這些問題,不是只有社會科學才會遇到。
近年來,像端到端模型(End-to-End Model)這類帶有黑箱(Black Box)特性的模型,在研究它們受到影響或刺激後的反應時,我們也會碰到一個問題:觀察到的變化,到底應該歸因給什麼?
當然,黑箱不代表實驗條件就一定不可控。但如果我們想研究介入造成的效果,因果推論裡的工具,就有機會派上用場。
我們其中幾篇做探針模型(Probe Models)的研究觀測實驗,也用到了 DiD。因此,今天就來介紹一下這個很有意思的方法。
介紹完這些前提知識,也該正式進入雙重差分法了。因為它在社會科學與政策評估裡比較常見,這篇也會先從這個角度來介紹。
二、DiD 到底在做什麼?
首先,DiD 的目的是:
在相關假設成立的前提下,估計某項政策或介入(Treatment)對結果變數 的因果效果。
對,我們要看的是因果關係。
舉個例子。
假設政府在某個城市實施最低工資政策,而另一個城市沒有實施。我們想知道:
「最低工資政策,是否真的提高了工人的薪資?」
但有個問題:即使沒有政策,薪資也可能因為通膨或景氣而上升。
因此,我們不能單純比較政策前後的薪資,就把增加的部分全部算到政策頭上。
DiD 的解決方式是:
先算實驗組的前後變化,再扣掉控制組的前後變化。
這裡岔個話。其實我認為,DiD 展現了一個做研究時很重要、也很通用的想法:當結果受到多個因素共同影響時,我們不能只觀察端到端的結果,就替整個變化給出單一解釋,而是要盡力把已知可能影響結果的因素,納入評估與比較。
當然,不是說用了 DiD,所有不可控因素就會自動消失。只是我覺得,這種先去想「還有什麼可能造成變化」的思路,本身就很重要。
好,回到 DiD。
剛剛是一個比較白話、直覺的說法。接下來,我們用一組具體的數字,把它拆開來看。
假設政府推出一項政策,提供員工職業訓練,希望提高他們的薪水。
我們想研究的問題是:
「參加職業訓練,真的會讓薪水增加嗎?」
現在有兩群人:
- Treatment group(實驗組,也稱處理組):有參加職業訓練的人。
- Control group(控制組):沒有參加職業訓練的人。
這裡的分組,不代表研究者一定做了隨機分派。
我們在職業訓練開始前,以及結束後,分別觀察兩組人的平均薪水,得到下面這組示意資料:
| 組別 | 訓練前 | 訓練後 |
|---|---|---|
| 有參加訓練的人(Treatment) | 100 | 140 |
| 沒參加訓練的人(Control) | 80 | 100 |
這裡的數字,可以先想成兩組人的平均時薪。
1. 先只看參加訓練的人
接下來,我們暫時把控制組遮起來。
| 組別 | 訓練前 | 訓練後 |
|---|---|---|
| 有參加訓練的人 | 100 | 140 |
我們觀察到,訓練前的平均時薪是 100,訓練後是 140。
所以,薪水增加了:
到這裡,都還只是簡單的減法。
但是,這個 40,真的是職業訓練造成的嗎?
不一定。
因為在這段期間,也可能發生其他事情,例如:
- 整體經濟變好,大家的薪水都上漲。
- 通貨膨脹,雇主普遍調薪。
- 政府同時實施了其他提高薪資的政策。
所以,即使這些人沒有參加訓練,他們的薪水也可能上漲。
這就是為什麼,我們不能直接說:
「職業訓練讓薪水增加了 40。」
2. 再看看沒有參加訓練的人
剛剛我們已經知道,參加訓練的人,薪水從 100 增加到 140。但這個增加的 40,不一定全部來自職業訓練。
那現在,我們把沒有參加訓練的人拿回來看。
| 組別 | 訓練前 | 訓練後 |
|---|---|---|
| 沒參加訓練的人 | 80 | 100 |
他們的薪水也增加了:
這就很有意思了。
因為這群人根本沒有參加職業訓練,薪水卻也上漲了 20。
這告訴我們什麼?
可能是這段時間整體經濟變好,或者大家的薪水普遍上漲。
因此,Treatment group 增加的 40 裡面,可能有一部分,即使沒有訓練也會發生。
3. 現在,來理解第二次減法
整理一下,目前我們知道兩件事:
| 組別 | 薪水變化 |
|---|---|
| Treatment group:參加訓練的人 | |
| Control group:沒有參加訓練的人 |
而我們真正想知道的是:
如果沒有參加職業訓練,Treatment group 的薪水,原本會增加多少?
這個問題沒辦法直接觀察,因為他們已經參加訓練了。
所以,DiD 會利用 Control group 的變化來推估。
假設沒有職業訓練時,兩組的平均薪水都會增加 20,那麼:
- Treatment group 實際增加了 40。
- 其中有 20,是我們估計即使沒有訓練,也會增加的部分。
- 剩下的 20,才是我們想估計的訓練效果。
所以:
這就是 Difference-in-Differences,雙重差分的直覺。
對了,這裡的「差分」,可以先理解成相減,不用懷疑自己。
那「雙重差分」,白話說就是減兩次囉。但注意喔,英文是 Difference-in-Differences,更準確地說,是「差異中的差異」。
其實很簡單,依然是減兩次,但這兩次是不同層次的減法。第一次,算出每一組的前後變化;第二次,再把兩組的變化拿來相減。從剛剛上面的示範,就可以看出來了。
嗯。
到這裡,說實話,已經把 DiD 的基本算法解釋完了。對,就是這麼簡單。
如果你只是想知道 DiD「在算什麼」,那其實可以先走了。
但接下來,才要進到 DiD 有趣的地方,也就是:為什麼這樣算,可以拿來估計因果效果?
三、為什麼需要平行趨勢假設?
接下來,要介紹的是 平行趨勢假設(Parallel Trends Assumption)。
我們慢慢來,先不急著看數學定義,也不急著直接介紹它。
先回答一個問題:為什麼需要這個假設?
回到剛才的職業訓練例子:
| 組別 | 訓練前 | 訓練後 | 薪水變化 |
|---|---|---|---|
| Treatment | 100 | 140 | |
| Control | 80 | 100 |
我們算出:
然後說:「職業訓練讓薪水增加了 20。」
但是,這裡其實有個問題。
為什麼我們可以把 Control group 的薪水成長 ,當成 Treatment group 在沒有訓練時,也會發生的薪水成長?
萬一 Treatment group 本來就比較有競爭力,即使不接受訓練,薪水也會增加 30 呢?
這時候,剛才的 DiD 估計,就會出問題。
因此,我們需要一個假設,來支持這個推論。
這就是平行趨勢假設。
知道這個需求後,我們再來介紹,Parallel Trends 到底是什麼。
最直覺的定義是:
如果沒有政策介入,Treatment group 和 Control group 的結果變數,平均而言應該具有相同的變化趨勢。
注意這句話裡,最關鍵的部分:
「如果沒有政策介入」。
平行趨勢不是說,兩組實際觀察到的結果,一定要一直平行。
而是說,在「沒有政策」的假想世界裡,兩組的平均變化應該平行。
我們用圖來看。
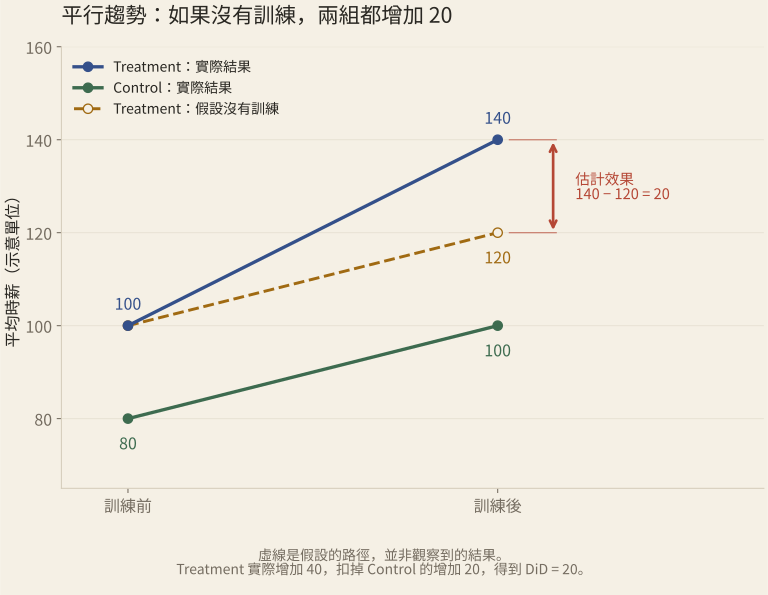
這裡需要特別觀察三件事:
- Treatment 和 Control 在政策前,可以有不同的薪水水準。
- 如果沒有政策,兩組應該具有相同的變化量,這是我們做的假設。
- Treatment 在政策後的實際結果,可以因為政策效果,偏離原本的平行路徑。
所以,平行趨勢不要求兩組起點相同,只要求沒有政策時的平均變化相同。
這個差別很重要,接下來我們用兩個情境,把它看得更清楚一點。
四、平行趨勢成立,和不成立,差在哪裡?
1. 情境 A:平行趨勢成立
假設沒有職業訓練時,兩組原本會這樣變化:
| 組別 | 訓練前 | 訓練後,假設沒有訓練 |
|---|---|---|
| Treatment | 100 | 120 |
| Control | 80 | 100 |
兩組都增加 20。
所以,即使 Treatment 的起點比 Control 高 20,也不影響平行趨勢成立。
而 Treatment 接受訓練後,實際變成了 140。
那麼:
在這個例子裡,DiD 正確估計了訓練效果。
因為我們用 Control 的變化,推估 Treatment 沒有接受訓練時的變化,剛好就是對的。
2. 情境 B:平行趨勢不成立
現在,假設 Treatment group 的人,本來就處於快速成長的產業。
即使沒有職業訓練,他們的薪水也會增加 30。
| 組別 | 訓練前 | 訓練後,假設沒有訓練 |
|---|---|---|
| Treatment | 100 | 130 |
| Control | 80 | 100 |
Treatment 本來就會增加 30,Control 卻只會增加 20。
這時候,如果 Treatment 接受訓練後,實際薪水是 140,那真正的訓練效果應該是:
但我們用 DiD 算出來的是:
把兩個結果放在一起看:
| 要比較的結果 | 數值 |
|---|---|
| 真正的訓練效果 | 10 |
| DiD 估計值 | 20 |
DiD 高估了 10,因為兩組原本就有不同的成長趨勢。
也就是說,Treatment 本來就會多成長的那一部分,被我們一起算成了職業訓練的效果。
這就是為什麼,平行趨勢假設這麼重要。
剛才看起來只是減兩次,但如果我們對「原本會怎麼變」的推估有問題,減完的數字,也就不能照原本的方式解釋了。
五、那研究者怎麼知道,平行趨勢成立?
但我相信,大家看到這裡,應該會有一個更深的問題。
「那研究者怎麼知道,平行趨勢假設成立?」
答案是:我們通常無法直接證明它成立。
因為我們觀察不到,Treatment group 在同一個時間、同一個世界裡,「沒有接受政策」的結果。
他們已經接受政策了,沒有另一個同時發生、卻沒有接受政策的版本,可以拿出來直接比較。
所以,我們通常會透過政策實施前的歷史資料,觀察兩組原本的走勢是否相似,再結合政策背景,判斷這個假設是否合理。
例如,我們有政策實施前三年的資料:
| 組別 | 2020 | 2021 | 2022 |
|---|---|---|---|
| Treatment | 70 | 80 | 90 |
| Control | 50 | 60 | 70 |
這三年,兩組都是每年增加 10。
這是支持平行趨勢合理性的證據,但不能保證政策實施後,如果沒有介入,兩組也一定繼續平行。
所以,歷史資料可以幫我們判斷,卻沒有辦法直接把那個沒有發生的結果變出來。
這也是使用 DiD 時,需要把研究背景一起考慮進去的原因。除了平行趨勢,實際研究也還要注意,政策是否提前影響了行為,以及控制組有沒有同樣受到政策波及等問題。這篇先不展開,先把最核心的假設理解清楚。
六、好了,這次真的要結尾了
介紹了這麼多,也該做個結尾了。
說實話,這次的筆記非常社會科學化。
嗯,這也是我沒想到的。
但畢竟 DiD 發光發熱的地方,本來就有很大一部分是在經濟學、政策評估這些領域裡。用這些例子介紹,確實也比較容易看懂,它到底想解決什麼問題。
那我自己也認為,如果未來我們更多地去探索神經網路模型的 Black Box 機制,研究各種介入到底造成了什麼影響,也有可能會更常用到這個 method。
當然,具體還是得看研究設計,不能因為模型是黑箱,就直接把 DiD 套上去。
但這畢竟也需要時間,去推動學界從不斷拼 SOTA,到真正願意坐下來,慢慢拆解模型裡到底發生了什麼。
也因此,未來會不會普及,大概還是只能等待時間的推動了。
客官怎麼看
看完有話想說,留在這裡。罵我也可以,罵別人更好。
可用 GitHub 登入,或以筆名題字;Email 選填。地區章依網路位置辨識,臺灣可顯示縣市;編號用來區分留言。