P-value 到底是什麼
| 內容分類 | 學習筆記 |
|---|---|
| 筆記系列 | 統計學 |
| 筆記篇幅 | 短篇筆記 |
| 學習狀態 | 持續整理 |
| 本篇主題 | 假設與顯著性 |
從丟十次硬幣開始,理解 p-value 在問什麼,以及為什麼過了 0.05,也不代表事情就這樣定了。
與其先用定義來講解什麼是 p-value,不如我們直接用一個比較直觀的例子,去體會 p-value 是怎麼運作的。
假設有人拿一枚硬幣給你,說:
「這枚硬幣是公平的,正反面機率都是 50%。」
現在你連續丟 10 次,結果出現了 9 次正面、1 次反面。
你會不會開始懷疑硬幣不是公平的?
應該會吧!
因為如果硬幣真的公平,出現這樣的結果似乎不太尋常。
但問題來了:就算硬幣真的公平,也有可能因為運氣,剛好出現 9 次正面啊!
那麼,我們接下來就一定要問:
如果這枚硬幣真的公平,那出現像剛剛這樣極端,甚至更極端的結果,機率有多大?
這個機率就是 p-value。這裡先假設每次投擲互相獨立,而且我們是在丟之前,就決定好丟 10 次。
這裡應該先來開個小灶。我相信大家理解到這裡,已經有一點接受困難了,這確實是個很繞的概念。
其實我們丟十次硬幣,是想用結果判斷:正反面失衡到這個程度,在公平硬幣的假設下,到底有多不常見?
注意,我們現在不是在問「這枚硬幣公平的機率是多少」,也不是只問「剛好 9 次正面的機率是多少」。我們是在暫時接受「硬幣公平」之後,計算目前這麼極端,或更極端的結果有多容易出現。
至於多低才算統計顯著,還需要先訂一個門檻。這個等一下再說。
回到計算。
這次我們懷疑的是「硬幣不公平」,不管它偏向正面還是反面都算,所以使用雙尾檢定。
剛才丟出 9 次正面的例子,若我們把「9 正 1 反」「9 反 1 正」,甚至「10 次都是同一面」都算進去:
也就是大約 2.15%。
分子裡的兩個 10,分別是那唯一一次反面或正面,可以出現在十次投擲中的哪個位置;兩個 1,則是全部正面與全部反面。公平且獨立投擲時,這 種正反面序列出現的機率都相同。
意思是:假設硬幣真的公平,那麼丟 10 次,出現至少 9 次同一面的機率,大約只有 2.15%。
因為這種程度的失衡不常見,所以我們開始懷疑「硬幣公平」這個假設。但這不等於硬幣只有 2.15% 的機率是公平的。
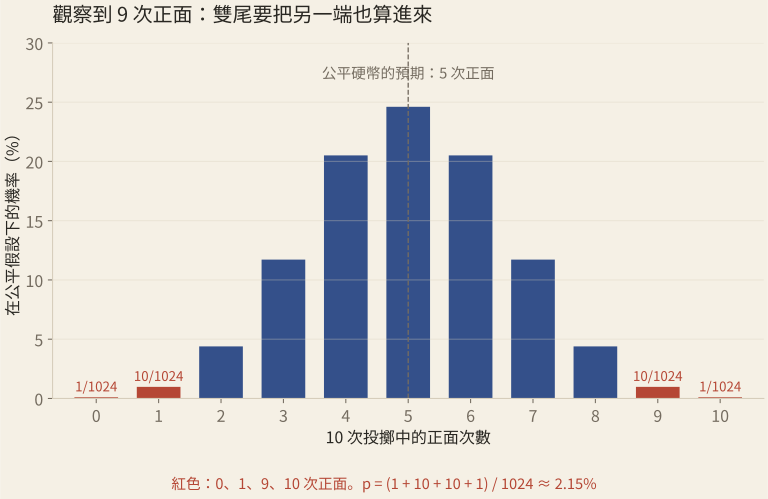
如果一開始問的是「硬幣是否偏向正面」,只把偏向正面的方向算進去,那就是另一個單尾檢定,p-value 也會不同。不能看到結果之後,才挑比較容易顯著的問法。
好,舉完剛剛的例子後,我們可以用一句白話去介紹 p-value:
如果原本的假設是對的,那現在看到的結果有多不尋常?
那在 p-value 的正式介紹裡,應該要這樣說:
p-value 是在虛無假設(Null Hypothesis,)及檢定模型的其他假設成立的前提下,觀察到檢定統計量像目前這麼極端或更極端的機率。
對,沒錯,就是這麼鬼話。
「檢定統計量」可以先理解成:我們用哪個數字,衡量結果偏離原本假設的程度。像剛剛的雙尾硬幣例子,就是看正面次數離預期的 5 次有多遠。
這裡其實藏了幾個重要設定,也就是:
- (虛無假設):拿來比較的基準,常見的是沒有效果、沒有差異。這裡是正面機率等於 50%。
- (對立假設):我們想檢驗的另一種情況。這裡是正面機率不等於 50%。
這兩個會是理解 p-value 的重要前提。它們也會影響我們怎麼界定「更極端」。
有趣的是,算 p-value 的時候,我們都是先用 去假設。
那為什麼呢?其實從上面的直觀例子來看,就很明確了:如果連公平硬幣丟出什麼結果算正常,都沒有一個比較標準,我們要怎麼判斷 9 次正面到底奇不奇怪?
這裡的基準是依照研究問題設定的,不一定是現實中最常見的情況,也不是指某種「常態分布」。
總結來說就是:
我們需要先有一個「比較的基準」,才能判斷實驗結果到底有沒有特別奇怪。
那好,上面其實用到了很多「這東西到底有多奇怪」的說法。這是一個極為口語化的說法,而如果實驗還需要做出決策,就得把判斷規則寫清楚。
於是這裡會用到另一個符號 ,叫做顯著水準。
簡單說, 就是一個事先設定的門檻。當 ,我們就稱結果在這個水準下具有統計顯著性,並依規則拒絕 ;沒有達到門檻,則不能宣稱顯著。後者也不等於已經證明 是對的。
門檻要先訂,是因為我們想控制誤判的風險:在 真的成立,而且檢定假設也成立時,長期重複做同樣的檢定,把它錯誤拒絕的機率,要控制在 以內。這叫做第一類錯誤。
所以 ,不是說「這次結論有 5% 的機率是錯的」。它管的是這套檢定規則長期下來的誤判率。
那其實這樣一看,問題就來了,也算是使用 p-value 時常見的兩個通病:
- 門檻二分化。
- 裁判兼球員。
先看門檻二分化。其實剛剛大家也會覺得怪怪的吧,所以只要 p 值低過 的門檻,就具有統計顯著性囉?
那要是只低一點點呢?例如 和 ,放在 的門檻兩邊,一個叫顯著,一個叫不顯著。但它們真的能支持兩種截然不同的結論嗎?
聽起來有點繞,白話就是:數字只差一點點,標籤卻突然換邊了。
門檻可以讓決策有一致的規則,但證據不會因為跨過 0.05,就突然從沒有變成有。統計顯著也不代表效果很大,或是實際上很重要。
看完門檻二分化,另一個問題才比較嚴重,也就是裁判兼球員。
什麼叫裁判兼球員呢?當然就是看完結果,才回頭改判斷規則囉。
我們剛剛說了,門檻可以依研究目的與誤判的代價而變動,但這件事應該在看結果之前決定。舉一個直觀的例子:
一個研究者一開始規定 。
研究做完發現:
這時研究者想:
「啊!不顯著耶!那我把 改成 0.10 好了!」
於是:
欸。
突然就變成統計顯著。
但你看,p 值明明還是 0.08,改變的是研究者的門檻。 如果看完結果才為了顯著而改規則,原本事先設定的誤判風險控制,也就不能照樣宣稱了。
另一種相關的做法,則是反覆換分析方法、刪樣本或多試幾個變數,直到找到夠小的 p 值,再只報告那個結果。這通常叫做 p-hacking(p 值操弄)。
事後改 和反覆分析到顯著,操作上不完全一樣,但都有同一個問題:看完比賽結果,才替自己改規則。當然,如果一開始就合理訂好 ,那是另一回事。
這裡再說個小趣聞。相信如果你有做研究,你可能會跳出來反駁我,說:
「嘿,你這樣說不對,不是都說 就是具有統計顯著性嗎?這個 門檻可不是我自己定的,是學界公認的。」
那這確實值得拉出來解釋一下。先來 fact-check 一下喔: 其實不是什麼自然法則,也不是數學證明出來的唯一正確標準。
更白話地說,0.05 的流行有歷史與使用習慣的原因。統計學家 Fisher 曾把它當成一個方便使用的顯著性標準,後來它逐漸成為常見慣例。不是數學突然發現,宇宙在 0.05 這裡有一條線。
蠻有趣的小故事,但這裡就不展開了。
那我們討論了 p-value 這麼多問題,難道就不應該廢除這個指標嗎?
其實也不能這麼一刀切。如果使用假設檢定的目的是做明確決策,例如某項治療的試驗是否達到事先規定的療效標準,訂好決策門檻就很有用,因為我們必須控制錯誤決策的風險。當然,要不要批准治療,還得看安全性、效果大小等其他證據。
但如果目的是理解世界、探索某個變因的影響,單靠 來決定一切,就可能過度簡化證據。
實務上,一個負責任的研究,不會只靠 p-value 這單一項統計指標,而是一起看效果大小、信賴區間、研究設計,以及其他研究的結果,再來解釋。
參考資料
- NIST:Critical Values and p Values:p-value、顯著水準,以及事先設定檢定門檻。
- 美國統計學會:關於統計顯著性與 p-value 的聲明:p-value 的解讀限制、門檻與完整報告。
- Kennedy-Shaffer(2019):Before p < 0.05 to Beyond p < 0.05:0.05 門檻與顯著性檢定的歷史。
客官怎麼看
看完有話想說,留在這裡。罵我也可以,罵別人更好。
可用 GitHub 登入,或以筆名題字;Email 選填。地區章依網路位置辨識,臺灣可顯示縣市;編號用來區分留言。