論文導讀——二之一
| 導讀篇章 | 二之一 |
|---|---|
| 適用版本 | RG.2.2.35863.33447 |
| 作者身分 | 作者 |
| 閱讀範圍 | 核心問題與實驗 |
在開始之前
TAAI 2026 會議快到了,剛好藉這個機會,重新複習一下自己的這篇研究,也順便整理成導讀,帶各位看看這次究竟想回答什麼問題。
和上一篇導讀一樣,這個系列不一定依照論文章節的順序進行,而會以較適合理解本作的方式,逐步拆開研究問題與實驗證據。
這次會先從具體的例子開始,再接回論文中的圖表。各位可以先跟著想:電腦拿到了什麼資訊、還缺少什麼,以及每一個實驗究竟想排除哪一種疑問。演算法的完整推導,則暫時留到後續再談。
若有希望另外介紹的基礎概念,也可以到許願池提出。
先從直覺理解
想像有人唸了一句英文,我們希望電腦把它寫成文字。看起來只是「聽到一句話,再把它打出來」,但中間至少可以拆成兩個問題:
- 這段聲音包含哪些音素?
- 這串音素,應該對應到哪些詞?
這裡的 音素(Phoneme),可以先理解為語言中用來區分詞義的聲音單位。例如英文的 cat,可以用 K AE T 表示它的三個音素。AE 雖然寫成兩個字母,在這套記號裡卻是一個音素。因此,數音素和數英文字母,是兩件不同的事。
現在,假設我們暫時跳過第一個問題,直接將一串正確的音素交給電腦,但不告訴它詞與詞之間的邊界。
事情就已經沒有那麼簡單了。
先用一個方便理解的示意。忽略實際說話時的重音與銜接差異,下面這串音素,可以有兩種切法:
音素序列:AY S K R IY M

切法一:AY | S K R IY M  → I scream
切法二:AY S | K R IY M  → ice cream
第一種是「我尖叫」,第二種是「冰淇淋」。這個例子只是用來說明分詞歧義,不是論文中的實驗案例。
可以看到,即使每個音素都已經提供正確,電腦仍然需要判斷在哪裡切開,以及每一段對應哪個詞。 而且,像 right 與 write 這樣的同音詞,就算切的位置沒有問題,拼字也還不一定能唯一決定。
那麼,這個從音素還原成詞的過程,究竟有多少需要透過神經網路學習?
這就是本作的切入點。我先把發音字典與詞頻資訊準備好,使用一個不訓練神經網路映射的解碼器,觀察它在正確音素上能做到多好;接著再逐步加入音素錯誤,看詞錯誤會如何改變。
這樣一來,我們就能分開問:是前面沒有聽對,還是後面已經拿到聲音單位,卻沒有把它組合成正確的詞?
不過,這次主要量的是後半段。 實際聲音中的口音、背景雜訊與發音變化,仍然需要由聲學階段處理,所以後半段的成績,不能直接當成完整語音辨識系統的成績。
「零參數」,究竟省略了什麼?
看到論文標題中的 Parameter-Free,可能會先想到:這個系統是不是完全不使用資料,也沒有任何需要調整的設定?
這裡需要先說清楚:本作所說的零參數,指的是詞彙解碼階段不需要訓練神經網路映射。字典、詞頻與需要調整的設定,仍然存在。
我們可以先把這個解碼器想成一個查字典、比較切法的程序。它需要三類資訊:
- 哪些詞存在,以及它們怎麼唸。 這由發音字典提供。例如看到
K AE T,可以查到cat;看到K AE P,則可以查到cap。 - 哪些詞比較常見。 當幾種切法或拼字都對得上音素時,詞頻提供一個偏好。論文稱它為單詞先驗(Unigram Prior),這裡的 unigram 表示單獨看每個詞的頻率,還沒有把前後文完整納入。
- 遇到不完全吻合的情況,要怎麼取捨。 例如可不可以略過一個無法配成詞的音素、容不容許發音有少量差異,以及這些做法要扣多少分。
實驗使用的字典是 CMUdict,包含 122,787 個詞、132,690 種發音;因為一個詞可能有多種發音,後一個數字會比較大。移除重音標記後,使用 39 個 ARPAbet 音素符號,前面的 K、AE、T 就是這套符號中的例子。
詞頻則從 LibriSpeech train-clean-100 的文字轉錄統計。也就是說,我沒有讓詞彙解碼器透過聽錄音,學習如何從音素變成詞;但它確實從文字統計,取得了哪些詞比較常出現的資訊。
接下來,程序會沿著整串音素查找可能的詞,替不同組合評分。這裡使用動態規劃(Dynamic Programming):將前面已經算過的最佳結果保留下來,再往後比較,最後回推出整段序列分數最高的組合。
為什麼需要比較整段?因為眼前找到一個很常見的詞,不代表剩下的音素還能順利組成其他詞。如果太早決定切開,後面可能反而更難處理。
至於前面提到的扣分與容錯設定,則是在另外保留的資料上調整,不是看到最後報告的成績,再逐句修改答案。
因此,字典與詞頻已經給了系統相當多的知識。這個實驗真正想檢查的是:這些資訊都已經準備好之後,單靠明確的查找與評分程序,究竟能把詞還原到什麼程度?
如果音素完全正確,還會認錯嗎?
我們先從最理想的輸入開始。
要做這個實驗,必須先準備一份沒有額外辨識錯誤的音素輸入。做法是拿原本的參考文字,逐詞查字典,取每個詞在字典中的第一種發音,再串成一條音素序列。
接著,拿掉的是詞與詞之間的邊界,句子邊界仍然保留。解碼器知道這一句到哪裡結束,卻不知道裡面包含幾個詞、應該在哪裡切開。
所以,這裡的「正確音素」,意思是沒有額外破壞的字典發音,不是把真人錄音中所有實際發音變化,都完整標註出來。
還有一項設定需要先交代:如果參考文字裡有字典查不到的詞,那個詞就不會產生輸入音素,但評分時仍然要算它。 假設一句話裡有個字典沒有收錄的人名,那個人名的發音不會出現在輸入,原本的參考文字卻還保留它。因此,這個實驗同時受到字典覆蓋率限制,不能理解成每個參考詞的聲音都已完整提供。
評估使用英文朗讀語音資料集 LibriSpeech 的 dev-clean 切分。其中 20% 的語句保留作為設定調整,其餘 2,163 個語句、43,370 個參考詞,用於報告結果。
在這個條件下,最佳設定得到的 詞錯誤率(Word Error Rate,WER)為 5.66%。
這個數字怎麼算?先把輸出的詞和參考文字對齊,看看總共需要換掉幾個詞、補回幾個漏掉的詞,以及刪掉幾個多出的詞,再將這些編輯次數,除以參考文字的詞數。
例如,假設參考文字共有 100 個詞,輸出需要 3 次替換、2 次補回與 1 次刪除,才能改成參考文字,那麼 WER 就是 。這只是計算示意,不是本作的實驗數據。
因此,5.66% 可以先理解為:每 100 個參考詞,平均約需要 5.66 次詞層次的編輯,才能修正輸出。 它不是「有 5.66% 的句子整句辨識失敗」,也不能直接換寫成句子的正確率。
實驗也以語句為單位,反覆重新抽樣、計算 WER,得到 [5.41%, 5.92%] 的 bootstrap 區間。這讓我們能看到:評估語句的組成有所變動時,整體成績大約有多大的不確定性。
那麼,既然音素沒有被額外破壞,這些錯誤又從哪裡來?
我們看主文第 2 頁的 Table 1,其中將全部 2,453 個詞錯誤,依照對齊後的歸類規則,分配到互斥的類別:
| 錯誤類別 | 數量 | 占全部詞錯誤的比例 |
|---|---|---|
| 同音詞歧義 | 942 | 38.4% |
| 字典外詞(OOV) | 774 | 31.6% |
| 分詞錯誤 | 737 | 30.0% |
| 音素破壞 | 0 | 0.0% |
| 未歸類 | 0 | 0.0% |
表格來源:Po-Ting Lin,〈How Much of Speech Recognition Must Be Learned? A Parameter-Free Analysis of Lexical Decoding〉,DOI: 10.13140/RG.2.2.35863.33447,本次參考主文第 2 頁 Table 1 右半部。本表翻譯欄位名稱,保留原始數量與比例;比例的分母為 2,453 個詞錯誤,不是全部參考詞。歸類方式的補充說明,依據作者尚未公開的補充文件第 6 頁 §4.1。
同音詞就像前面的 right 與 write:發音對了,拼字仍然可能選錯。分詞錯誤則可以接回 I scream 與 ice cream 的示意:同一串音素,切在不同位置,就成了另一組詞。字典外詞的問題,則是剛才提過的字典覆蓋限制。
表格中的 38.4%,是 942 個同音詞錯誤,占全部 2,453 個詞錯誤的比例。這張表的分母是「已經發生的錯誤」,前面 WER 的分母則是「全部參考詞」。 兩種百分比回答的問題不同。
這樣歸類的用途,是讓我們能從一個總分,回頭找到一批具體案例,檢查究竟是哪裡出了問題。每個錯誤依固定規則只歸入一類;沒有未歸類的錯誤,不代表每次錯誤都只受單一因素影響。
另外,主文還報告了一個 4.32% 的字典外詞與同音詞診斷數字,與 5.66% 相差約 1.34 個百分點。這項診斷同時考慮字典沒有收錄的詞,以及參考詞具有更常見同音詞的情況。
不過,4.32% 不能當成所有解碼器都無法突破的理論下限。 我在尚未公開的補充文件第 6–7 頁 §5 中,也進一步釐清這個解讀。像 right 與 write,只看發音可能分不出來,但放回一句話裡,上下文仍可能告訴我們該選哪個詞。
因此,1.34 個百分點只是這兩個統計數字的差距,不能據此說「不管換什麼方法,最多只能再改善 1.34 個百分點」。
音素錯一點,詞會跟著錯多少?
前面先回答了「音素沒有被額外破壞時,詞可以還原到什麼程度」。但真正接上聲學模型之後,送進來的音素,當然不可能永遠正確。
那麼,前面多犯一點音素錯誤,到了詞彙階段,究竟會付出多少代價?
要回答這件事,我們先不要同時更換聲學模型、字典與解碼設定,否則最後成績變差,很難判斷是哪一項改變造成的。這次先固定後面的解碼器,只逐步改變送進去的音素品質。
先看看,一個音素錯誤會改變什麼
還記得前面的 cat 嗎?它的字典發音可以寫成 K AE T。這裡每個以空格隔開的符號,代表一個音素;AE 雖然寫成兩個字母,在這套記號裡仍是一個音素。
如果最後的 T 被換成 P,就會變成 K AE P,剛好能對上另一個詞 cap。
原本的音素:K AE T  → cat
改錯一個後:K AE P  → cap
這個示意想說的是:只改變一個聲音單位,就可能讓字典匹配轉向另一個詞。但解碼器最後會不會真的選出 cap,還要看其他候選與分數,不能把這個示意當成實測輸出。
而且,錯誤還不只替換一種。少掉一個音素,是刪除;多出一個原本沒有的音素,是插入。例如原本的 K AE T,也可能變成 K AE,或 K S AE T。
對解碼器來說,這些改變可能讓原本的詞對不上字典。由於輸入沒有詞邊界,它也可能改從前後取另一段音素,嘗試組成不同的詞。於是,一個局部錯誤,有機會連帶改變附近的切法。
這也是為什麼,我們不能只數「前面錯了幾個音素」,就直接認定「後面一定會錯同樣多個詞」。
實驗怎麼逐步加入錯誤?
這次的做法,是從前面那份字典音素序列出發,人工加入替換、刪除與插入。這裡的「加入雜訊」,指的是修改音素符號序列;這一階段不需要重新播放錄音,也沒有在音檔裡加入環境聲。
替換成什麼音素,也有指定的混淆分布。它依據發音特徵的重疊程度,安排音素之間被混淆的相對機率,而不是讓所有音素都以相同機率互換。這讓我們能在一套明確的錯誤生成方式下,逐步提高破壞強度。
每一個強度都使用三個不同的隨機種子重複測量。可以將隨機種子理解為決定「這次在哪些位置、產生哪些錯誤」的起點;改變種子,就能避免只看某一份剛好比較容易或比較困難的破壞結果。
整個流程可以分成四步:
- 從參考文字產生字典音素,拿掉詞邊界。
- 按照指定的破壞強度與混淆分布,修改音素序列。
- 將修改後的序列交給同一組解碼設定,還原成詞。
- 分別計算輸入端的音素錯誤率,以及輸出端的詞錯誤率。
接著再提高破壞強度,重複這個流程。這條曲線比較的是同一個解碼器,面對不同品質的音素輸入時,成績如何改變。 不是每增加一點錯誤,就替解碼器重新挑一組最有利的設定。
音素錯誤率怎麼算?
這裡使用 音素錯誤率(Phoneme Error Rate,PER),量輸入究竟被改變了多少。計算方式和前面的 WER 相似,只是將比較單位從「詞」換成「音素」:
例如,假設參考音素共有 100 個,對齊後發現有 3 次替換、1 次刪除與 1 次插入,PER 就是 。這同樣只是計算示意。
為什麼要強調「對齊後」?因為多出或少掉一個符號,會讓後面的位置跟著移動。像 K AE T 變成 K S AE T,實際上只多了一個 S;如果直接按第幾個位置逐一比較,卻可能連後面原本正確的 AE、T 都算錯。因此,必須先尋找能將兩串序列互相轉換的最少編輯次數。
也因此,設定的破壞率,是我們產生錯誤時使用的控制量;PER 則是序列實際產生之後,重新對齊量到的結果。 兩個數字不保證相等,圖上使用的是後者。
這裡還有一項評估範圍要保留:WER 使用全部 2,163 個報告語句;PER 使用其中參考詞全部在字典內的 1,576 個語句。其餘 587 個語句,因為缺少完整的字典音素參考,只從 PER 評估排除,仍然計入 WER。因此,這兩個比率不只比較單位不同,使用的語句集合也有差異。
接下來,怎麼讀這張圖?
主文第 3 頁的 Figure 1,把每組條件得到的 PER 與 WER 放在同一張圖上:
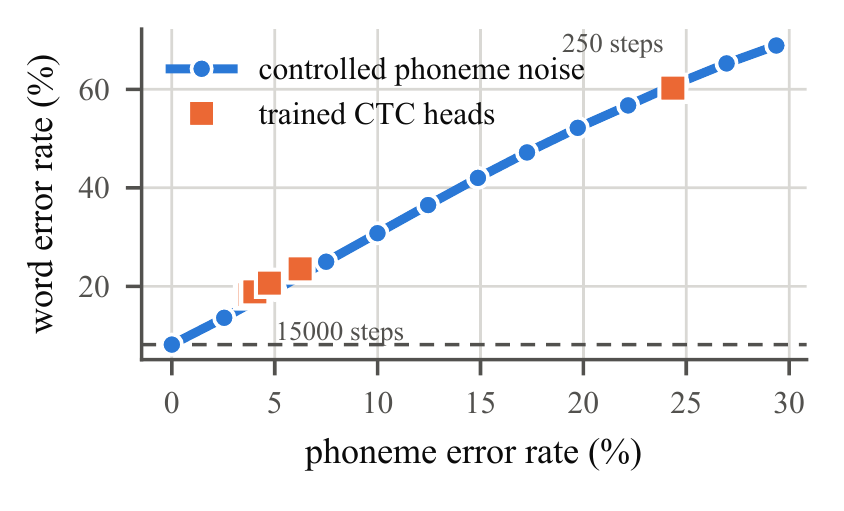
我們先看藍色圓點與連線。橫軸是 PER,往右代表送進來的音素錯得更多;縱軸是 WER,往上代表還原出來的詞,需要更多編輯才能修正。
所以,每個藍點都在回答同一件事:當輸入音素錯到這個程度時,固定的解碼器,最後會產生多少詞錯誤? 橘色方塊是聲學模型的檢查結果,下一節再看。底下的水平虛線,則是這組解碼設定在沒有額外破壞時,量到的 8.18% WER。
可以看到,藍點隨著 PER 增加而往右上方移動,而且大致排列成一條直線。在約 0%–29% PER 的測試範圍內,用直線去近似這些測量結果,得到:
先看最重要的 2.11。它是這條回歸線的斜率,也就是沿著橫軸增加一點時,縱軸大約增加多少。
例如,將 PER = 10% 代入,得到的 WER 約為 ;換成 PER = 11%,則約為 32.51%。輸入錯誤率只多了 1 個百分點,輸出的詞錯誤率,卻多了約 2.11 個百分點。這兩個數字是依回歸式計算的示例,不是額外的實測結果。
換成一句比較容易記的話,就是:
在這組解碼與破壞條件下,PER 每增加 1 個百分點,WER 大約增加 2.11 個百分點。
不過,這不表示每錯一個音素,就一定會錯 2.11 個詞。 PER 的分母是音素數,WER 的分母是詞數;「兩種比率如何變化」和「單一錯誤造成幾個錯詞」,是不同的問題。
用一個刻意簡化的例子來看。假設有 100 個詞、共 400 個音素,原本全部都能正確還原。現在加入 4 個音素替換,PER 就是 1%。如果這 4 個錯誤分別落在 4 個詞,而且各讓那個詞被換成別的詞,沒有其他連帶錯誤,那麼 WER 就會是 4%;但如果 4 個錯誤都落在同一個詞,而且只讓那一個詞被換錯,WER 就是 1%。
這個例子沒有模擬整個解碼器,只是讓各位看到:音素錯誤率相同,錯誤出現的位置不同,詞錯誤率仍可能不同。實際解碼還可能透過容錯找回原詞,也可能因為分詞改變而影響鄰近的詞,所以必須真正跑完流程,才能量到結果。
近似直線,為什麼值得注意?
前面提到,一個錯誤可能改變附近的切法。因此,我們原本可以懷疑:當錯誤越來越多,它們會不會彼此干擾,讓後面的損失越來越大?
如果有很強的這種效應,圖形就可能越往右、上升得越陡。例如 PER 從 5% 增加到 6% 的代價還很小,但從 20% 增加到 21% 時,WER 卻突然大幅增加。
這次量到的結果,在測試範圍內大致維持相近的上升速度。錯誤會讓成績變差,但每多一點音素錯誤所帶來的額外代價,沒有隨著整體錯誤率提高而持續變大。 這才是「近似線性」在這裡的意思。
式子旁邊的 ,則是在描述這條直線和測量結果貼合的程度。它接近 1,支持這組結果用直線近似相當合適;它不是音素或詞的辨識正確率,也不是說每一個語句都會貼著這條線。
還要留意,斜率 2.11 本身大於 1。因此,本作量到的是兩種錯誤率之間近似固定的放大關係,不能把「沒有越來越陡」寫成「詞層次的錯誤完全沒有被放大」。
最後,再看公式中的 9.3%。如果直接把 PER = 0 代入,回歸線會落在這個高度;但它是用整段測量結果找出一條近似直線後,得到的截距,不等於直接測得的零破壞成績。
在接近原點的地方,實際曲線略有彎曲。這組針對有雜訊輸入調整的設定,零破壞時量到的是 8.18% WER,比回歸截距低約 1.1 個百分點,也就是圖中的水平虛線。
至於前面的 5.66%,是另外針對正確音素選出的最佳設定。可以把三個數字分開記:5.66% 回答「為正確音素挑好設定,能做到多好」;8.18% 回答「這次量曲線的固定設定,沒有額外破壞時做到多好」;9.3% 則是近似整段曲線時,回歸線在縱軸上的位置。
所以,這條線比較適合用來估計:在相同條件下,如果能把音素錯誤率降低一些,詞錯誤率大約有多少改善空間? 它提供的是整體表現的經驗換算,不是保證每一句話、每一種錯誤都按固定比例變化。
本節曲線、斜率、截距與零破壞結果,依據主文第 2–3 頁 §4.2 與 Figure 1。三個隨機種子的重複測量,以及 PER、WER 使用不同評估語句集合的細節,另依據作者尚未公開的補充文件第 5 頁 §3.3。文中的發音例子、簡化計數與代入算式,均為導讀說明,未作為新增實驗結果。
人工加入的錯誤,能代表聲學模型嗎?
看到這裡,可能會有另一個疑問:人工加入的錯誤,畢竟是我們自己安排的。真正的聲學模型,會不會剛好特別容易把某些音素聽錯,或在某些位置連續出錯,讓後面的詞更難還原?
因此,只有人工破壞的曲線還不夠,我也需要讓實際聲學模型來產生音素,再看看結果會落在哪裡。
這次先用 Whisper-base 將錄音轉成聲音特徵,並固定這部分的模型權重,再訓練一個約 317 萬參數的 BiLSTM CTC 音素辨識頭。各位可以先把後面這串名稱理解為:接收聲音特徵,並學習輸出音素序列的神經網路。
在同一次訓練過程中,我取出七個不同階段的模型存檔,也就是七個檢查點(Checkpoint)。它們學習的程度不同,提供的音素品質也不同;但後面都接上相同的詞彙解碼流程。
因此,每個檢查點也會得到一組 PER 與 WER,畫到 Figure 1 裡,就是橘色方塊。圖中的訓練步數標示,可以幫助我們辨認較早與較晚的檢查點。
這時要看的,是橘色方塊離前面那條回歸線有多遠。假設某個檢查點的 PER,代入回歸線後預期 WER 是 30%,實測卻是 31%,兩者的差就是 +1 個百分點,這個差稱為殘差。這只是示意它的算法。
本作七個檢查點的 WER 殘差,約落在 −0.46 到 +1.35 個百分點。也就是說,把真正聲學模型產生的音素交給同一個解碼器後,得到的詞錯誤率,仍然相當接近人工破壞實驗所預期的範圍。
這讓前面的曲線多了一項實際用途:它不只描述人工修改符號的結果,也能作為這次聲學模型輸出的參考。
不過,七個檢查點來自同一次訓練,不是七次獨立訓練的驗證。 換一種模型、另一份語料,或另一種錯誤分布,是否仍然接近這條線,還需要再做實驗。
另外,這裡也能看清楚「零參數」的範圍:後面的詞彙解碼器不訓練神經映射,前面的音素辨識頭卻確實有訓練,使用的 Whisper 特徵也來自預訓練模型。整個驗證流程,並不是完全沒有經過學習的系統。
哪些設計真的有幫助?
前面說明了整個解碼器能做到什麼程度。但裡面用了字典、詞頻與幾種額外規則,究竟是哪些設計帶來幫助?
最直接的做法,就是一次改一項,看看成績怎麼變。這稱為消融實驗(Ablation)。例如拿掉詞頻,如果成績大幅變差,就表示在這組條件下,詞頻對結果很重要。
但這裡還要多做一步:每個變體都重新調整設定。 因為拿掉某個評分項之後,原本適合的扣分大小,可能就不適合了。如果完全不重新調整,我們量到的差距,就可能混入「設定沒有跟著改好」的影響。
主文第 4 頁的 Table 2,得到以下結果:
| 設定 | 正確音素 WER | 相對參考設定的變化 | 有雜訊音素 WER | 相對參考設定的變化 |
|---|---|---|---|---|
| 參考設定 | 7.81% | — | 36.26% | — |
| 移除單詞先驗 | 37.30% | +29.49 | 62.15% | +25.89 |
| 移除長度項 | 7.81% | +0.00 | 36.51% | +0.25 |
| 移除片段合併 | 5.66% | −2.16 | 35.08% | −1.19 |
| 加入 1 次編輯的詞彙匹配 | 7.80% | −0.01 | 25.23% | −11.03 |
表格來源:Po-Ting Lin,〈How Much of Speech Recognition Must Be Learned? A Parameter-Free Analysis of Lexical Decoding〉,DOI: 10.13140/RG.2.2.35863.33447,本次參考主文第 4 頁 Table 2。本表翻譯欄位名稱,保留原始數值;變化量的單位為百分點,負值表示改善。有雜訊條件的設定破壞率為 ε = 0.08,不等於實測 PER 必為 8%。
讀這張表,先看第一列。這次用來比較的參考設定,在正確音素下得到 7.81% WER,在有雜訊音素下得到 36.26% WER。每一列的變化量,都各自和這兩個數字比較。
因此,正值表示 WER 上升,也就是變差;負值表示 WER 下降,也就是改善。例如移除單詞先驗後,正確音素的 WER 從 7.81% 變成 37.30%,差了 29.49 個百分點。
為什麼少了詞頻,差距會這麼大?因為字典能告訴程序「這樣切,可以組出哪些詞」,卻不會自動告訴它「這幾種組合裡,哪些詞平常比較常出現」。拿掉詞頻偏好後,即使音素正確,選詞與分詞仍然可能明顯變差。
接著看長度項。它是在評分時,另外給較長的匹配區段一些獎勵。但在這次使用的評分方式下,拿掉它,正確音素的結果仍是 7.81%;有雜訊時,也只差了 0.25 個百分點。因此,不能只因為「鼓勵較長的匹配」聽起來合理,就認定它一定有實質貢獻。
片段合併則是在初步解碼之後,再對切出的片段做合併處理。結果,拿掉這一步,正確音素的 WER 反而從 7.81% 降到 5.66%。前面報告的最佳成績,就是這一列,不是第一列的參考設定。
最後,再看「加入 1 次編輯的詞彙匹配」。它的意思是,輸入區段和字典發音之間,只要相差不超過一次音素替換、刪除或插入,就仍可列為候選,同時為差異付出扣分。
這可以接回 K AE T 與 K AE P 的例子。若只容許完全相同的發音,後者就無法直接匹配 cat;若容許一次編輯,cat 就仍可能保留在候選裡,交給後面的整體評分決定。這不保證一定選回 cat,但至少不會因為一個音素不同,就先把它排除。
在正確音素下,這項容錯幾乎沒有改善:7.81% 變成 7.80%。但在有雜訊時,WER 卻從 36.26% 降到 25.23%,改善了 11.03 個百分點。
這個差別很有意思。音素本來就正確時,幾乎不需要靠容錯找回候選;音素被破壞之後,容錯才有明顯發揮的空間。同一個元件有沒有用,必須連同它面對的輸入條件一起看。
另外,每一列都代表相對於參考設定的一項改動。不能將各列的改善量直接相加,就當成把所有改動放在一起的成績;合起來之後,還需要另外評估。
那麼,語言模型還能幫什麼忙?
前面已經用了詞頻,為什麼還要加入語言模型?
因為「一個詞平常有多常見」,和「它適不適合出現在這一句裡」,仍然是兩件事。像前面的 right 與 write,單獨看發音無法決定;但放到 Please write your name. 這樣的上下文裡,就多了能幫助選詞的資訊。這是用來理解上下文作用的示例。
這次使用凍結的 GPT-2,也就是沿用已訓練好的模型,不在這個實驗裡更新它的權重。在搜尋過程中,它會根據上下文,對音素證據已經允許的候選重新評分。
這裡可以分成兩層來想:前面的字典匹配先決定「哪些詞可以列入考慮」,語言模型再協助判斷「這些候選裡,哪些比較適合目前的上下文」。如果正確詞根本沒有被產生為候選,單靠重新評分,也無法把它選回來。
接著調整的是語言模型的權重:權重為 0,就不使用它的評分;提高權重,則讓上下文偏好對最後選擇有更大的影響。
主文第 3–4 頁 §4.4,在 400 個語句、設定破壞率 ε = 0.05 的條件下,將權重從 0 掃到 1。直接結合對數分數時,WER 從不加入語言模型的 28.97%,改善到權重 0.5 時的 25.28%,降低了 3.69 個百分點。
所以,在這組音素候選限制下,上下文確實還能提供額外幫助。但這裡的輸入帶有破壞,評估也只使用 400 個語句,不能拿 25.28% 和前面正確音素下的 5.66% 直接比較,說語言模型讓成績變差。
還有一個容易被忽略的問題:兩種分數的數值範圍,會影響權重的意義。
先想一個純粹的評分例子。假設一項分數大多在 0 到 1,另一項卻在 0 到 100;即使給它們相同權重,後者仍很容易主導總分。此時調整權重,可能大部分是在補償數值範圍的差異,而不是單純表達我們有多重視其中一項。
因此,本作比較直接結合對數分數,以及先在每組候選內標準化、讓語言模型分數的範圍比較一致之後,再結合的做法。
在測試的權重範圍內,表現先改善到一段較寬的最佳區域,再隨權重提高而退步,並不是越依賴語言模型就越好。這組實驗讓我們能實際觀察:候選是否涵蓋正確詞、上下文偏好占多大比重,以及分數尺度怎麼處理,會如何一起影響結果。
這仍然是指定模型、候選限制與搜尋設定下的測量,還不足以保證換成任何語言模型,都會有同樣的權重變化結果。
回到這篇研究想回答的問題
現在再看論文標題中的「有多少必須被學習」,應該就比較容易理解它的範圍了。
我們先準備好發音字典與詞頻,再拿掉詞邊界,讓一個不訓練神經網路映射的程序,嘗試把音素組回詞。正確音素下,它得到 5.66% WER;逐步加入音素錯誤之後,又能量到兩種錯誤率之間近似線性的關係,並接回聲學模型的輸出做檢查。
這些結果讓我們看到,在這組資源已經給定的條件下,明確的查找、評分與搜尋程序,就能完成相當一部分的詞彙重建。透過拆開階段,我們也能知道某一項改善,究竟是在處理音素錯誤,還是在改善分詞與選詞。
不過,這還不能回答所有語音辨識有多少「必須」被學習。實驗仍然限於英文朗讀語料、指定字典與先驗;字典與詞頻本身提供的知識,也必須算進我們使用的資源。換一種語言、另一種說話方式,或另一個解碼器,結果都還需要重新檢查。
但至少,下一次看到一個詞辨識錯誤時,我們可以問得更具體:前面真的把聲音聽錯了嗎?字典裡有沒有這個詞?詞邊界切對了嗎?還是發音其實對得上,卻因為詞頻或上下文,選成另一個拼字?
這也是這次會議前,我想重新整理清楚的研究脈絡。
本篇主要參考:Po-Ting Lin,〈How Much of Speech Recognition Must Be Learned? A Parameter-Free Analysis of Lexical Decoding〉,DOI: 10.13140/RG.2.2.35863.33447,本次導讀使用的四頁主文。
作者補充說明另依據〈Related Work, Problem Formulation, and Significance of the Study〉,包括 §3(形式定義與評估)、§4(錯誤分析與元件作用)、§5(研究範圍)。該文件目前尚未公開,相關內容由作者於本篇導讀中補充交代。 本篇的表格為主文數值的中文整理,圖版為主文 PDF 裁切,各處已標示來源與處理方式。
客官怎麼看
看完有話想說,留在這裡。罵我也可以,罵別人更好。
可用 GitHub 登入,或以筆名題字;Email 選填。地區章依網路位置辨識,臺灣可顯示縣市;編號用來區分留言。