論文導讀——一之一
| 導讀篇章 | 一之一 |
|---|---|
| 適用版本 | 2606.25483v2 |
| 作者身分 | 主要作者 |
| 閱讀範圍 | 核心構想 |
在開始之前
這個系列不一定依照論文章節的順序進行,而會以較適合理解本作的方式,帶各位逐步掌握研究的核心問題與證據。
另外,本篇定位為論文導讀,不會像學習筆記一樣,將每個基礎觀念都拆解得十分細緻。建議各位在具備相關基礎後閱讀;若有希望另外介紹的概念,也可以到許願池提出。
這次會以概念與理論脈絡的拆解為主,暫不深入數學推導。更完整的數學細節,可能留待後續筆記延伸。
先從直覺理解
在深入細節之前,我認為應該先用比較直覺的方式,說明這篇論文最重要的發現:
即使左右眼的隨機採樣完全獨立,兩張影像的雜訊「變異數空間分布」,仍然可以具有很強的相關性。
想像我們用電腦模擬一個房間,再透過左右兩台虛擬攝影機,產生一對立體影像。在固定場景與攝影機設定下,我們讓:
- 左眼使用自己的一組隨機數進行渲染。
- 右眼使用另一組獨立的隨機數。
- 因此,左右眼各次渲染產生的 Monte Carlo 雜訊,在樣本層次彼此獨立。
這個假設沒有錯。
但我發現,樣本層次的獨立,不妨礙兩眼的變異數場具有相似的空間結構。 這裡的變異數場,描述的是各個像素在多次獨立渲染中,結果會波動多少。
而且,只要將左右影像按照正確的 視差(Disparity) 對齊,這種相關性就會變得非常明顯。
更重要的是,神經網路可以利用這個特徵,判斷左右影像中哪些位置彼此對應。
這代表,合成資料可能提供一種額外的匹配線索。更精確地說,論文關注的是渲染過程產生、不能單由影像亮度重述的變異數結構;真實攝影機也可能有跨視角的變異數相關性,因此不能將這個差異簡化成「真實影像完全沒有相關性」。
相關基礎可參閱先前的學習筆記:蒙地卡羅、關於渲染那檔事,以及 Pearson 相關係數。
統計上,是否存在相關結構?
上面的直覺結論,其實包含兩個需要分開回答的問題:
- 統計上,左右眼的變異數場是否具有相關結構?
- 學習上,這個結構是否能成為神經網路可利用的線索(cue)?
我們先從第一個問題開始,看論文第 4 頁的 Table 1。
| 測量方式 | Mitsuba 3 | Blender Cycles |
|---|---|---|
| 未對齊的變異數相關性 | 0.360 ± 0.036 | 0.159 ± 0.061 |
| 經 Disparity 對齊後 | 0.754 ± 0.016 | 0.743 ± 0.044 |
| 非玻璃材質(對齊後) | 0.779 ± 0.011 | 0.726 ± 0.034 |
| 玻璃材質(對齊後) | 0.301 ± 0.102 | 0.487 ± 0.079 |
表格來源:Po-Ting Lin,〈Independent Samples, Correlated Variance: A Learnable Cross-View Cue in Path-Traced Stereo Data〉,arXiv:2606.25483v2,第 4 頁 Table 1。本表翻譯欄位名稱並調整列序,保留原始數值;數字為跨場景平均值 ± 標準差。Mitsuba 3 使用 20 個場景,Cycles 使用其中 5 個場景,兩者皆以每眼 30 次獨立渲染估計變異數場。
這裡的數字是 Pearson correlation coefficient(皮爾森相關係數)。其值越接近 1,表示兩個變異數場的空間分布越具有正線性相關。
以 Mitsuba 3 的整體結果為例:
- 對齊前
- 0.360
- 對齊後
- 0.754
這個結果支持我們的第一個主張:
左右眼的變異數場不只是大致相似,而是具有與物體幾何對應位置一致的空間結構。
因此,論文第 2 頁的 Figure 1,值得更仔細地看。
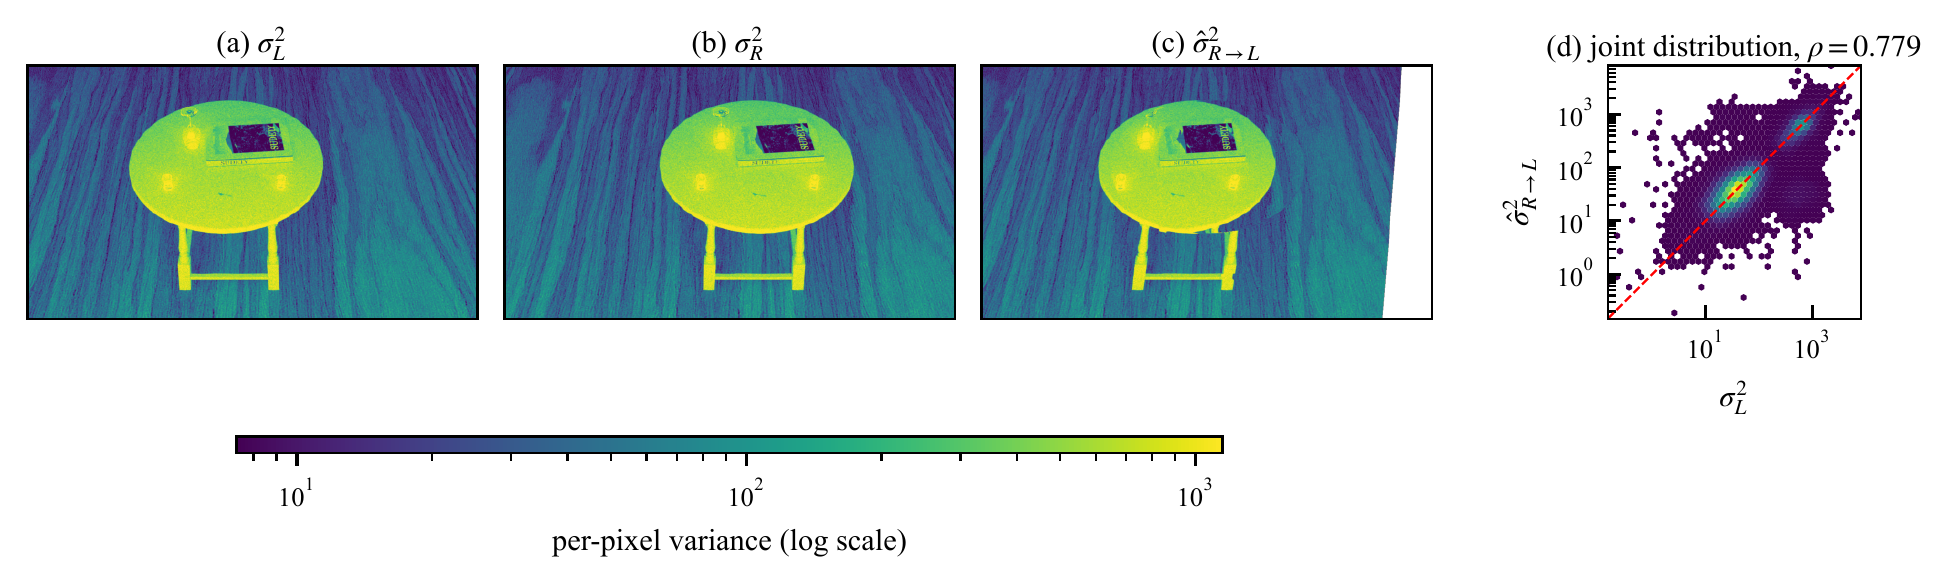
圖中將右眼的變異數場,依照真實視差(Ground-truth Disparity)對齊到左眼座標。比較左眼與對齊後的右眼,可以看到桌子與背景的變異數結構高度重合。這張圖呈現的是單一場景的示例,前面的表格則整理跨場景結果。
為什麼玻璃的相關性反而比較低?
看到 Table 1,可能會有另一個疑問:玻璃明明是很難渲染的材質,雜訊也往往比較大,為什麼對齊後的相關性,反而低於非玻璃區域?
要理解這件事,需要先分清楚:雜訊的大小,與變異數場在兩眼之間是否具有一致的空間結構,是兩個不同的問題。
前者在問某個像素的渲染結果會波動多少;後者則在問,左眼哪些位置波動比較大、哪些位置比較小,這個分布在對齊後的右眼是否也相似。玻璃的波動可以很大,卻不一定在兩眼的對應位置呈現相同的分布。
關鍵就在於:Disparity 對齊的是幾何位置,左右眼看向這個位置的方向,仍然不同。
先用以漫反射為主的表面來理解。兩眼對齊到同一個表面點後,共享的是這裡的光照、遮擋與間接光等場景條件。當對觀察方向不敏感的貢獻占主導時,兩眼所面對的積分問題比較相似,因此也較容易保留一致的變異數結構。
但玻璃的反射與折射,對觀察方向更加敏感。左右眼即使對應到同一個玻璃表面點,沿反射、折射方向連到的場景內容,以及 Fresnel 效應下的反射與透射分配,仍可能不同。這些差異會改變對結果重要的光路,也讓 Monte Carlo 估計的波動隨視角改變。
所以,即使幾何對齊正確,也不能期待兩眼在玻璃區域的變異數場完全重合。這個解釋關注的是材質的視角相依性;也不是說所有非玻璃材質都不受視角影響,光滑金屬等材質同樣可能有明顯的方向性。
另外,v2 也提出另一個可能因素:玻璃相關的光傳輸可能具有重尾(heavy-tailed)特性,少數很大的路徑貢獻,會讓有限次渲染估出的變異數本身不穩定,進一步影響測得的相關性。
這個「估出的變異數本身是否可靠」的問題,也延伸到我的另一篇研究:〈Characterising Per-Pixel Rendering Difficulty by Transport Mechanism〉(arXiv:2608.16730v2)。那篇從光傳輸機制出發,檢查有限樣本的變異數估計,在不同隨機種子與採樣預算之間是否穩定,並探討如何利用機制資訊修正初步的變異數估計,改善樣本配置。若想進一步理解重尾與變異數量測可靠性的關係,可以接著閱讀該篇的 §1、§5.1 與 §7。
不過,本篇立體研究的資料,尚無法清楚分離視角相依性與估計不穩定各自的影響,因此不能將其中一項寫成已經單獨證實的唯一原因。 另一篇對量測可靠性的分析,提供了延伸理解的依據;要判斷兩種因素各自造成多少跨視角相關性的下降,仍需要針對本篇問題進行分離檢驗。
這部分依循論文 v2 第 7 頁 §7 Discussion 的解釋。反射、折射與 Fresnel 的基礎,則可接回先前的 BSDF 筆記。
但這裡需要特別注意:相關性高,還不能證明神經網路真的會使用這項線索。
學習上,這個結構能成為線索嗎?
為了回答第二個問題,我設計了一個小型的 Siamese Network(孿生網路)。可以將它理解為一個極為簡化的立體匹配探針:只讓它看變異數場,不提供 RGB 影像的亮度與色彩資訊。
任務是:給定一個左眼影像區塊(patch),在兩個右眼候選區塊中,選出真正與它對應的那一個。
這稱為 2AFC(Two-Alternative Forced Choice,二選一強迫選擇)。如果只是隨機猜測,正確率就是 50%。
論文第 6 頁的 variance-only probe 實驗,得到以下結果:
- 正常變異數場
- 約 78.8%
- 破壞跨視角對齊後
- 約 50%
數據整理自上述論文 v2,第 6 頁 §6.2 與 Table 2。兩次訓練初始化的正常條件正確率為 78.77%、78.82%;破壞對齊後為 50.17%、49.80%。此處四捨五入,以呈現主要差異。
正常條件下,網路的正確率明顯高於隨機猜測;打亂跨視角的對齊關係後,同一個模型的表現就回到隨機水準。
這是本作支持線索可被利用的重要受控實驗證據:
當跨視角變異數結構存在時,網路能利用它完成匹配;當這個結構被破壞,原先高於隨機水準的匹配能力也隨之消失。
不過,約 78.8% 的結果,來自每眼 30 次獨立渲染估計出的變異數場,是一個較理想化的實驗條件。 它不能直接當成一般單次渲染影像的匹配結果。
因此,我也進一步檢查更貼近一般合成資料的條件:每眼只有一次渲染,同時保留影像亮度資訊。
在這個設定下,我透過雙重差分法(Difference-in-Differences,DiD),比較正常資料訓練的模型與去相關資料訓練的控制模型,在跨視角結構被破壞後,各自下降多少,再扣除控制模型的下降量。得到的淨差異約為 2.40 個百分點,支持這個 probe 在亮度資訊可用時,仍對該線索存在一定程度的依賴。完整設定與結果見原文 §6.4(第 6–7 頁)。
這裡的 2.40 是百分點,不是相對變化百分比。若想先了解這個比較方式,可參閱雙重差分法的學習筆記。
但這個結果仍有明確的解讀範圍:它支持所設計的 probe 能利用這項線索,不代表完整的 Stereo Network 也必然如此,更不能直接推論它會改善或損害真實資料上的表現。
先在核心構想停下來
「一之一」就先到這裡。
這篇論文的內容相當密集,本篇先抓住兩層核心證據:左右眼的變異數場具有與幾何對應一致的相關結構;而這個結構,也能成為小型匹配網路可學習、可利用的線索。
至於是否會有「一之二」,進一步拆解背後的數學細節與更多實驗,仍取決於之後的時間與精力。不過,讀到這裡,應該已經能掌握這篇論文在 v2 所提出的核心構想,以及目前證據所支持的範圍。
論文來源與圖表引用
- Po-Ting Lin(2026),Independent Samples, Correlated Variance: A Learnable Cross-View Cue in Path-Traced Stereo Data。arXiv:2606.25483v2|固定版本 PDF。
- 本篇由論文主要作者撰寫。Figure 1 為原圖節錄;Table 1 為翻譯與重排;探針實驗數據為原文結果的摘要,各處已標示來源及處理方式。所有引用均限定於 v2。
- 延伸閱讀:Po-Ting Lin(2026),Characterising Per-Pixel Rendering Difficulty by Transport Mechanism。arXiv:2608.16730v2。用於延伸討論光傳輸機制、變異數量測可靠性與樣本配置;本篇立體研究的實驗數據仍以 2606.25483v2 為準。
客官怎麼看
看完有話想說,留在這裡。罵我也可以,罵別人更好。
可用 GitHub 登入,或以筆名題字;Email 選填。地區章依網路位置辨識,臺灣可顯示縣市;編號用來區分留言。