機率密度函數
| 內容分類 | 學習筆記 |
|---|---|
| 筆記系列 | 圖學 |
| 筆記篇幅 | 短篇筆記 |
| 學習狀態 | 持續整理 |
| 本篇主題 | 機率與採樣 |
哪裡比較容易抽到?抽得不平均,為什麼還能算對?用兩張圖和一個例子理解 PDF。
學 Path Tracing 的時候,一直看到 PDF 這個詞。
這裡的 PDF 是 Probability Density Function,機率密度函數。
我覺得理解它最有用的切入點,就是先分清楚這兩個東西:
白話說, 是「我要算什麼」, 是「我要怎麼抽」。
要算的東西不變,但抽樣方式可以由我們選擇。這就是重要性抽樣的出發點。
接下來先看 。它要回答的是:
我在一個範圍裡隨機抽數字,哪裡比較容易被抽到?
PDF 就是用來描述這件事的。曲線比較高的地方,附近一小段區間就比較容易被抽到。
而在重要性抽樣裡,我們還可以主動選擇這條曲線,安排樣本要多抽哪裡、少抽哪裡。
一、先讓大家機會一樣
假設我要從 0 到 1 之間抽一個數字,而且希望每個地方都一樣容易被抽到。
那就選 ,範圍是 ,範圍外的密度是 0。
這條線是平的,所以相同寬度的區間,機會也相同:
- 抽到 0 到 0.2 之間的機率,是 20%。
- 抽到 0.8 到 1 之間的機率,也是 20%。
這就是均勻抽樣。
注意,這裡比較的是「一段區間」。對連續分布來說,抽到某個精確數字的機率是 0;我們說某個位置比較容易抽到,是在說它附近那一小段。
二、那我想多抽右邊呢?
可以,換一條曲線就好。
這次選 ,抽樣範圍仍然是 0 到 1,範圍外的密度一樣是 0。
這條線越往右越高,所以右邊比較容易被抽到。
同樣拿剛才那兩段來看:
| 怎麼抽 | 左邊:0 到 0.2 | 右邊:0.8 到 1 |
|---|---|---|
| ,平均抽 | 20% | 20% |
| ,偏向右邊 | 4% | 36% |
區間一樣寬,抽到的機率卻差很多。右邊現在是左邊的九倍。
這就是我覺得理解重要性抽樣時,很重要的一點:
我們可以主動選擇怎麼抽。 如果知道右邊對答案比較重要,就可以讓更多樣本落在右邊。
PDF 本身只是描述分布的工具;「主動選擇」是我們在這個積分問題裡做的事。
三、曲線的高度,不是百分比
看圖的時候,要分清楚兩件事:
- 高度:這裡有多密,叫做機率密度。
- 某段曲線下的面積:抽到那段區間的機率。
所以剛才的 4% 和 36%,都是看面積算出來的。
像 ,在 的高度是 1.6。這不是說有 160% 的機率,只是在說這個位置的密度。
另外,PDF 也不能隨便畫。它不能低於 0,而且整條曲線下的總面積必須是 1,也就是 100%。畢竟抽出來的數字,總得落在某個地方。
那 4% 和 36% 怎麼算?
算曲線下的面積,就是積分:
整個範圍的面積也剛好是 1:
四、可是多抽右邊,不會把答案算歪嗎?
如果直接把抽到的值拿來平均,會。
你都刻意多抽右邊了,結果當然會比較偏向右邊的值。所以要做一個補償:每次算到的貢獻,都除以那個位置的 PDF。
先認識兩個符號就好:
- :抽到 時,我們要計算的貢獻。
- :我們用來抽樣的機率密度。
每次抽樣真正拿來平均的,是:
直覺上就是:比較常抽到的地方,每次少算一點;比較少抽到的地方,抽到時就多算一點。
同樣的原始貢獻,PDF 越大,除完就越小。這樣才能補償「有些地方抽得多、有些地方抽得少」的差別。
例如,要計算 在 0 到 1 之間的積分,並且用 抽樣:
| 抽到哪裡 | 原本貢獻 | 補償後 | |
|---|---|---|---|
| 0.1 | 0.2 | 0.5 | |
| 0.8 | 1.6 | 0.5 |
左邊不太容易抽到,原本的貢獻又小;右邊比較容易抽到,原本的貢獻比較大。除以各自的 PDF 之後,兩次算出來竟然一樣。
其實,在這個例子裡,只要抽到的 ,結果都是:
而 在 0 到 1 下方的面積,剛好就是 。這裡每次都能得到答案,是因為我們選的 PDF 和 的形狀剛好完全對上。
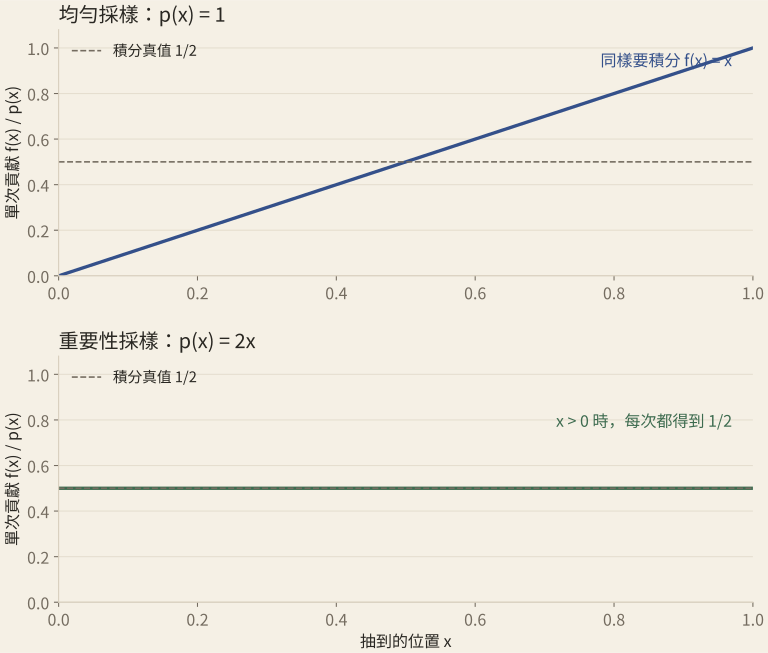
一般問題通常沒這麼剛好,單次估計還是會有誤差。不偏(unbiased)的意思,是想像把整套估計重做很多次,這些估計值的平均會趨近真正的答案。
還有一個前提:有貢獻的地方,要保留抽到它的機會。如果一整塊有貢獻的區域都永遠抽不到,就沒辦法靠補償救回來。
想看完整估計式與推導
我們要算的是 。依照 獨立抽出 個樣本 ,把補償後的貢獻平均:
不偏的精確意思,是 。它成立的原因是,期望值裡的抽樣密度,剛好和分母抵消:
前提是 絕對可積分,樣本真的依照 產生,分母使用相同的密度,而且在 的區域, 幾乎處處為正。白話說,就是不能漏掉有貢獻的一整塊區域;少數零測度位置不影響積分。
剛才 時的 沒有定義,但理想的連續抽樣抽到恰好 0 的機率為 0,因此不影響例子的結論。
五、所以為什麼要這樣抽?
因為我們通常沒辦法把每個地方都算一遍,只能抽一些樣本來估計。
如果某些地方對答案的貢獻很大,我們就希望多花一些樣本在那裡。再用 PDF 補償,讓結果仍然不偏。
選得好的話,每次算出的加權貢獻就比較接近,答案比較不會忽大忽小。放到渲染裡,通常就能在相同樣本數下減少雜訊。
多抽重要的地方,抽完再補償。 這就是重要性抽樣的核心想法。
不過,重要的是「對答案有貢獻」,不是「右邊」。如果貢獻明明集中在左邊,卻拼命抽右邊,估計反而可能更不穩。
用符號說,我們希望 的形狀盡量貼近 。絕對值是因為 可能有負值,但 PDF 不能是負的。若 有正有負,就算形狀對上了,加權結果仍可能一正一負,未必像剛才的例子那麼穩。
六、放到 Path Tracing 裡呢?
在 Path Tracing 裡,我們常常是在抽「光線往哪個方向走」。
你可以把下面這些方法,看成不同的選方向方式:
- Uniform Hemisphere Sampling:在半球上,面積相同的方向區域有相同的抽樣機會。
- Cosine-weighted Sampling:比較常抽接近表面法線的方向,也就是比較朝向表面正上方。
- BSDF Sampling:看材質比較容易把光往哪裡散射,就偏向抽那些方向。
- Light Sampling:先選光源,再抽光源上的位置或朝向它的方向。
它們各自利用不同的資訊,去猜哪裡值得多抽。實際渲染也常把幾種方法搭配起來,叫做 MIS,之後可以再整理。
如果開始寫程式,還要注意 PDF 是「對哪種範圍」定義的:對光源表面面積算的密度,和對方向(立體角)算的密度,需要轉換後才能一起使用。
先記住這三個角色,就比較不容易混在一起:
- :我要算什麼。
- :我要怎麼抽。
- :抽到以後,這次要算多少。
延伸閱讀
- PBRT 第四版:Monte Carlo Basics:PDF 與 Monte Carlo 估計式。
- PBRT 第四版:Improving Efficiency:重要性抽樣與 MIS。
- PBRT 第三版:Sampling Light Sources:光源抽樣。
客官怎麼看
看完有話想說,留在這裡。罵我也可以,罵別人更好。
可用 GitHub 登入,或以筆名題字;Email 選填。地區章依網路位置辨識,臺灣可顯示縣市;編號用來區分留言。