執行緒與臨界區
| 內容分類 | 學習筆記 |
|---|---|
| 筆記系列 | 計算機基礎 |
| 筆記篇幅 | 長篇筆記 |
| 學習狀態 | 複習與整理 |
| 本篇主題 | 共享與同步 |
從兩條執行緒一起加 counter 開始,理解共享變數、競爭條件與鎖,再比較自旋鎖、互斥鎖、原子操作,以及 RP2350 雙核心的臨界區。
前面已經知道,程式碼裡的一行修改,不一定只有一個動作。像是讀回暫存器、改好位元,再寫回去,中間如果有人也動了那份資料,就可能把對方的修改蓋掉。
不過,先把硬體放旁邊。如果只是讓兩段程式,一起替同一個數字加 1,也會出問題嗎?
例如一邊加一百萬次,另一邊也加一百萬次。從 0 開始,最後應該是兩百萬吧?
數學沒有問題。但程式裡的「加 1」,到底是怎麼完成的,就不能只看那兩個加號了。
所以這次先在電腦上,用 C 和 pthread 做一個小練習,再接回 RP2350 的雙核心。畢竟如果連加法都會少算,應該還是先弄清楚,再讓兩顆核心一起忙。
一、同一個程式,可以有兩條執行路線嗎?
可以,這裡會用到執行緒(Thread)。
先從平常的 C 程式想起。程式進入 main(),執行第一件事,再執行第二件事。先不考慮中斷與其他背景機制,我們看到的是一條往下走的執行路線。
如果建立另一條執行緒,就能讓它從指定的函式開始做事,原本那條則繼續走自己的流程。
例如:
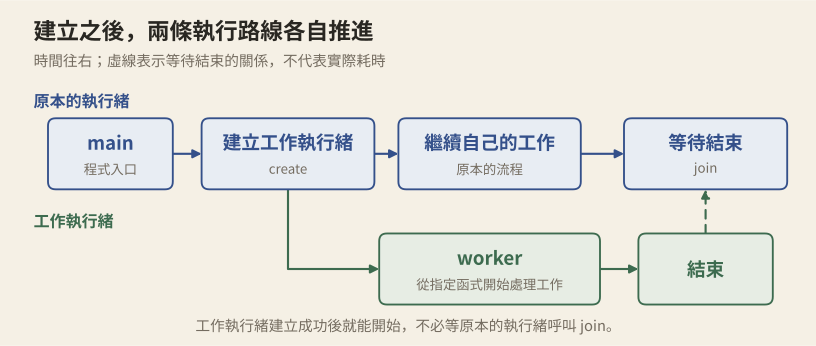
每條執行緒都有自己的執行位置與堆疊,可以各自呼叫函式、保存區域變數。但同一個行程裡的執行緒,會共用位址空間,因此也能存取同一份全域變數或動態配置的資料。
這裡的行程(Process),先理解成正在執行的程式實例就好。執行緒則是這個實例裡的執行路線。
所以,建立新執行緒,不是把整支程式和所有變數都複製一份。
有兩條執行緒,就一定同時在算嗎?
不一定。
如果只有一顆可用的 CPU 核心,作業系統可以讓兩條執行緒輪流取得執行時間。A 做一段,換 B 做一段,兩邊的工作都在推進,但同一個瞬間不一定同時執行。
如果有多顆可用核心,才可能讓 A、B 各自在不同核心上,同時執行。
前面這種工作交錯推進的關係,稱為並行(Concurrency);真的同時執行,則是平行(Parallelism)。中文譯法有時會不同,這裡先把英文和意思對起來。
執行緒是軟體的執行路線,核心則是執行指令的硬體。 兩條執行緒不保證分到兩顆核心,也不保證程式立刻快兩倍。
而且,即使只有一顆核心,兩條路線也可能在讀取與寫回之間被切換。後面要看的問題,不必等到真的雙核心才會出現。
二、用 pthread 建立,再等它做完
這篇電腦端的練習使用 POSIX Threads,通常簡稱 pthread。以下以 Linux 上的 C11 編譯環境為例,需要 C 編譯器與 pthread 支援;Windows 可以使用 WSL 裡的 Linux 環境。
我們先不碰共享計數,只讓兩條工作執行緒各自輸出一句話。
建立 thread-hello.c:
#include <pthread.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

static void check(int error, const char *operation) {
    if (error != 0) {
        fprintf(stderr, "%s: %s\n", operation, strerror(error));
        exit(EXIT_FAILURE);
    }
}

static void *worker(void *arg) {
    const char *name = arg;
    printf("Hello from %s\n", name);
    return NULL;
}

int main(void) {
    pthread_t a, b;

    check(pthread_create(&a, NULL, worker, "A"), "create A");
    check(pthread_create(&b, NULL, worker, "B"), "create B");

    check(pthread_join(a, NULL), "join A");
    check(pthread_join(b, NULL), "join B");

    puts("Both workers finished.");
    return 0;
}
編譯並執行:
cc -std=c11 -Wall -Wextra -O2 -pthread thread-hello.c -o thread-hello
./thread-hello
其中一種輸出順序是:
Hello from A
Hello from B
Both workers finished.
A、B 的先後可能交換,但最後那句會在兩邊都結束之後才出現。
1. create:讓另一條路線開始
先看這行:
pthread_create(&a, NULL, worker, "A");把四個參數拆開:
| 參數 | 在這裡的意思 |
|---|---|
&a | 把新執行緒的識別資料存進 a |
第一個 NULL | 使用預設的執行緒屬性 |
worker | 新執行緒開始執行的函式 |
"A" | 交給這次 worker 的參數 |
worker 的介面是接收一個 void *,並回傳一個 void *。這裡把參數當成字串使用;最後回傳 NULL,表示沒有另外交回結果。
呼叫成功後,新執行緒就可以開始執行,不必等到 main 呼叫 join。哪一條先取得執行機會,也不能只從原始碼的排列猜測。Linux man-pages:pthread_create
2. join:等指定的執行緒結束
pthread_join(a, NULL);這是讓呼叫它的執行緒,等待 A 結束。若 A 已經結束,就不必繼續等;第二個參數使用 NULL,表示這次不接收它的回傳值。Linux man-pages:pthread_join
注意,我們先把 A、B 都建立,再依序 join。
先 join A,不代表 B 得等到 A 結束才能開始。 B 在前面就已經建立,也能繼續執行。
如果寫成建立 A、join A,再建立 B,那就變成 A 全部做完,才輪到 B,和這次要觀察的情境不同。
前面的 check 則負責檢查錯誤。這些 pthread 函式會直接回傳錯誤碼,所以用回傳值交給 strerror,不是直接假設錯誤都存在 errno 裡。
參數只是傳進去,就不用管它活多久嗎?
還是要管。pthread_create 傳的是那個指標值,不會自動把指向的整份資料複製到另一條執行緒。
這裡使用字串常值,工作執行緒讀取時仍然有效。但如果傳入函式裡某個區域變數的位址,原函式已經結束,另一邊才開始讀,就會出問題。
同樣地,在迴圈裡反覆傳 &i,並不會替每條執行緒保留當時的 i。它們拿到的可能是同一個位置,還會和迴圈更新產生競爭。
後面各算各的例子,會先準備好兩份參數,再等兩邊 join 完才離開作用範圍。
三、兩邊都加 1,為什麼會少一次?
現在把工作改成計數。假設有一個全域變數:
static unsigned long counter = 0;兩條執行緒都執行:
counter++;因為存取的是同一個物件,這就是我們這次的共享變數。
「只是加 1,能有多複雜?」
先把這次對普通變數的更新,在概念上拆開:
- 讀取取得 counter 的舊值
- 計算舊值加 1
- 寫回把結果存回 counter
這是在說明讀取、修改、寫回的關係,不是保證編譯器一定產生剛好三條機器指令。但可以先用它看清楚,兩邊怎麼互相蓋掉。
假設 counter 原本是 10,發生了下面的交錯:
| 順序 | 執行緒 A | 執行緒 B | 共享 counter |
|---|---|---|---|
| 1 | 讀到 10 | 10 | |
| 2 | 也讀到 10 | 10 | |
| 3 | 算出 11 | 10 | |
| 4 | 也算出 11 | 10 | |
| 5 | 寫回 11 | 11 | |
| 6 | 寫回 11 | 11 |
兩邊都做了加法,但它們都是拿同一個舊值 10 來算。最後第二次寫入的仍然是 11,不是 12。
這就叫做更新遺失(Lost Update)。
程式是否正確,依賴了執行時誰先讀、誰先寫,卻沒有安排必要的同步,這是**競爭條件(Race Condition)**的典型例子。
不過,C 裡不只是「偶爾少加幾次」
前面的表格能解釋更新遺失,但不能把它當成未同步 C 程式的完整行為保證。
兩條執行緒存取同一個普通物件,至少一邊寫入,而且缺少必要的同步時,會構成 data race(資料競爭)。在 C11 的規則裡,這是未定義行為。C11 草案 N1570,第 5.1.2.4 節
所以,不能期待執行一個「沒有鎖的 counter 練習」,就一定只會得到比正確答案小的數字。偶爾剛好算對,也不能證明它沒有問題;關閉最佳化或加上延遲,都不是修正方式。
這次用表格觀察錯誤原因,接下來實際執行的計數程式,則會先把同步補上。
四、把不能被插隊的部分圈起來
現在知道問題出在哪裡了:A 還在用舊值計算時,B 也跑進來使用同一份資料。
那能不能讓 A 完成整次更新之後,B 再開始?
可以。需要這種保護的程式區段,叫做臨界區(Critical Section)。我們可以用**鎖(Lock)**安排互斥,讓同一時間只有一個持有者進入受保護的操作。
這裡先使用互斥鎖(Mutex):
pthread_mutex_lock(&counter_lock);
counter++;
pthread_mutex_unlock(&counter_lock);先取得鎖,再修改,完成後釋放。如果另一條執行緒已經持有同一把鎖,就要等對方放開,才能繼續。POSIX:pthread_mutex_lock
前面說「把讀、加、寫包成一步」,就是在說這個互斥效果。
鎖沒有把三個動作變成一條 CPU 指令,而是讓遵守同一把鎖的存取者,不能插進這次更新的中間。 它也建立必要的同步,讓後續取得鎖的一方能接續前面的修改。
實際讓兩邊各加一百萬次
建立 thread-counter.c:
#include <pthread.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

#define ITERATIONS 1000000UL

static unsigned long counter = 0;
static pthread_mutex_t counter_lock = PTHREAD_MUTEX_INITIALIZER;

static void check(int error, const char *operation) {
    if (error != 0) {
        fprintf(stderr, "%s: %s\n", operation, strerror(error));
        exit(EXIT_FAILURE);
    }
}

static void *worker(void *arg) {
    (void)arg;
    for (unsigned long i = 0; i < ITERATIONS; ++i) {
        check(pthread_mutex_lock(&counter_lock), "lock");
        counter++;
        check(pthread_mutex_unlock(&counter_lock), "unlock");
    }
    return NULL;
}

int main(void) {
    pthread_t a, b;

    check(pthread_create(&a, NULL, worker, NULL), "create A");
    check(pthread_create(&b, NULL, worker, NULL), "create B");
    check(pthread_join(a, NULL), "join A");
    check(pthread_join(b, NULL), "join B");

    printf("counter: %lu\n", counter);
    printf("expected: %lu\n", 2UL * ITERATIONS);
    check(pthread_mutex_destroy(&counter_lock), "destroy");
    return 0;
}
編譯並執行:
cc -std=c11 -Wall -Wextra -O2 -pthread thread-counter.c -o thread-counter
./thread-counter
正常完成時,預期輸出:
counter: 2000000
expected: 2000000
PTHREAD_MUTEX_INITIALIZER 替這把全域 mutex 做靜態初始化。最後兩條執行緒都已 join,確定沒有人還在使用它,再呼叫 pthread_mutex_destroy。
這裡最後的 printf 沒有另外取得鎖,是因為兩條工作執行緒都已結束,join 也完成了必要的同步,不再有人同時修改 counter。
但如果想在它們還在加的時候查看進度,讀取那一邊也得安排同步。不能只把寫入鎖起來,另一邊卻直接讀普通變數。
鎖不會自動跟著變數走
這點很容易想錯。
counter_lock 和 counter,只是我們約定一起使用的兩個物件。mutex 不會去搜尋程式裡所有出現 counter 的地方,替它們自動加鎖。
如果 A 用 lock_a,B 用另一把 lock_b,兩邊都可能成功取得自己的鎖,然後同時修改 counter。每邊都有寫 lock,仍然沒有保護到同一份資料。
所以要確認的,是所有可能同時存取這份共享資料的地方,是否遵守同一套同步規則。
五、拿不到鎖,就一直等嗎?
剛才只說「要等」,但等待也有不同做法。
最常一起看到的,就是自旋鎖(Spinlock)和互斥鎖(Mutex)。
1. 自旋鎖:留在原地,反覆嘗試
自旋鎖拿不到時,會持續檢查或嘗試取得鎖。可以先想成:
- 嘗試取得鎖
- 沒有取得繼續占用執行時間
- 再試一次直到成功取得
等的人仍然占用執行時間。另一顆核心如果很快就放開鎖,可能很快就能接手,不必另外付出掛起與喚醒的成本。Linux man-pages:pthread_spin_lock
但如果對方還要做很久,等待的一方就會花很多時間空轉。
更麻煩的是,如果持有鎖的執行緒暫時沒被排到執行,等的人再努力檢查,也不能替對方完成工作。
所以,自旋鎖適合考慮用在持有時間很短,而且執行環境允許這種等待方式的地方。不能只因為它名字裡有個「旋」,就覺得應該比較快。
2. 互斥鎖:等比較久時,可以先掛起
在有作業系統的環境裡,mutex 無法立即取得時,可以讓等待的執行緒進入阻塞狀態,把 CPU 執行時間交給其他可執行的工作,之後再喚醒。
平常說「mutex 會睡著等」,主要是在描述這件事,不是說呼叫一次 lock,就一定先睡一覺。
如果鎖本來就空著,通常能走很短的取得流程。具體實作也可能先嘗試短暫自旋,再進入睡眠等待。mutex 的互斥語意,和它底下採用哪種等待策略,要分開看。 Linux 核心:Mutex design
先把主要差別放在一起:
| 比較 | 自旋鎖 | 作業系統環境裡的 mutex |
|---|---|---|
| 拿不到時 | 忙等,持續嘗試 | 可以阻塞等待,讓出執行時間 |
| 等待成本 | 消耗執行時間與硬體資源 | 可能有掛起、排程與喚醒成本 |
| 要考慮的情境 | 很短的等待,且適合忙等 | 等待可能較長,可以被掛起 |
這張表是在比較典型行為,不是在替所有平台訂出相同實作。後面接到 Pico SDK 時,就會看到沒有一般作業系統排程器,也能提供 mutex 介面。
六、加了鎖,為什麼反而變慢?
現在計數正確了,但如果拿它來測時間,可能會發現:「兩條執行緒一起加,怎麼還不如自己加?」
先想想這次安排了什麼。
兩邊每加一次,都要取得鎖、修改、釋放鎖。大家搶的是同一個 counter,所以真正更新的那一小段,仍然只能輪流做。
也就是說,我們多了兩個工作者,卻沒有把那份共享工作分成兩份可以獨立完成的事情。
這裡的成本可能包括反覆取得與釋放鎖、競爭時的等待,以及作業系統的排程。若是在有快取的多核心電腦上,反覆修改同一份資料,還可能增加核心之間維持快取一致性的成本。
實際慢多少,要看硬體、實作和工作量,不能固定說一定慢一倍。前面的計數練習,是拿來看同步是否正確,也不能直接當成所有程式的效能排名。
1. 只鎖住需要共同決定的事情
假設工作改成:先替一筆資料計算結果,再把它累加到總和。
如果每筆的計算只使用自己的輸入,沒有讀寫共享狀態,就可以先在鎖外完成,再進去更新:
/* 流程片段:calculate 必須能獨立執行。 */
unsigned long value = calculate(input);

check(pthread_mutex_lock(&sum_lock), "lock");
sum += value;
check(pthread_mutex_unlock(&sum_lock), "unlock");
另一種寫法,是連計算也放進鎖裡:
/* 這樣會連 calculate 的時間,也一起占住鎖。 */
check(pthread_mutex_lock(&sum_lock), "lock");
unsigned long value = calculate(input);
sum += value;
check(pthread_mutex_unlock(&sum_lock), "unlock");
兩邊最後都能正確更新總和,但第二種寫法,會讓其他人連各自的計算都得等。原本能平行做的事,也被排成一列了。
所以,「鎖得越短越好」,是在說不要把與共享狀態無關、又可能花很久的事情,一起放進臨界區。
例如輸出大量文字、等待網路或刻意睡眠,都可能拉長其他人的等待。自旋鎖或關閉中斷的區段,更不能隨便放進這種工作。
2. 但不能為了縮短,把必要的保護拆掉
例如庫存還有一件,想做的是「有貨才扣一件」。這時檢查和扣除,必須一起保護:
check(pthread_mutex_lock(&stock_lock), "lock");
if (stock > 0) {
    stock--;
}
check(pthread_mutex_unlock(&stock_lock), "unlock");
如果把 stock > 0 移到鎖外,兩邊可能都先看到有貨,再各自進去扣一次。鎖內雖然更短了,邏輯卻壞掉。
因此,臨界區的範圍要看哪幾個動作必須維持同一個一致的判斷,不是只數裡面有幾行。
反過來,把一百萬次加法全部包在一把鎖裡,的確能減少 lock 次數,但也會讓整段迴圈無法同時更新。縮短持有時間、減少取得次數,以及保留平行工作,得一起考慮。
有鎖之後,還可能整個卡住嗎?
可能。例如 A 拿著鎖甲,等待鎖乙;B 拿著鎖乙,等待鎖甲。雙方都不放手,也都無法往下走,這就是死結(Deadlock)。
這和前一篇 PIO 的互相等待有點像:各自都在等另一邊先做完某件事,但誰都走不到那一步。
需要多把鎖時,要安排一致的取得順序。取得鎖之後,也要確保每條正常離開的路徑都會釋放,不能中途 return,卻把鎖留在手上。
另外,這裡的普通 mutex 沒有設定成可重入。同一條執行緒又去取得自己已持有的鎖,不是再加一層保護,可能讓自己也等不到。
七、加上 volatile,就能省掉鎖嗎?
前面的位元運算筆記已經用過 volatile,告訴編譯器,那些存取不能像普通變數一樣隨意省略。
所以會很自然地想:那共享計數改成這樣呢?
static volatile unsigned long counter = 0;這樣就能讓兩邊都看到最新資料,不必加鎖了吧?
先回頭看更新遺失的表格。即使 A、B 都真的去讀,也都真的去寫,它們仍然可能先讀到同一個 10,再各自寫回 11。
問題不只是有沒有執行讀寫,還包括整次更新能不能被其他更新插進來。
volatile 不會提供互斥,也不會把 counter++ 變成原子讀改寫,更不會建立一般執行緒資料交換所需的同步。原本的 data race 仍然沒有解決。GCC:Volatiles
就算硬體能一次完成某個對齊整數的讀取或寫入,也不等於整次「讀取、加 1、寫回」不可分割。硬體存取寬度和 C 的同步規則,都得各自確認。
所以,前面 mutex 版本的 counter 不需要加 volatile。需要的是正確使用同一把鎖,而不是替變數多放一個看起來比較認真的關鍵字。
八、不寫 lock,還能怎麼做?
看到這裡,可能會覺得:只是累加一個數字,每次都要進出 mutex,確實有點繞。
如果操作本身很單純,可以考慮原子操作(Atomic Operation)。如果根本不需要即時共享結果,則可以改成各算各的,最後再合併。
這兩種方式,處理問題的方向不太一樣。
1. 原子操作:直接使用不可分割的更新
在提供 C11 原子操作支援的環境中,可以使用 <stdatomic.h>。
延續第四節的 thread-counter.c,加入這個標頭,並把原本的 counter 宣告換成:
#include <stdatomic.h>

static atomic_ulong counter = ATOMIC_VAR_INIT(0);
再把 worker 改成:
static void *worker(void *arg) {
    (void)arg;
    for (unsigned long i = 0; i < ITERATIONS; ++i) {
        atomic_fetch_add(&counter, 1UL);
    }
    return NULL;
}
最後輸出計數的那行,改用原子讀取:
printf("counter: %lu\n", atomic_load(&counter));原本 counter_lock 的宣告,以及 pthread_mutex_destroy 那行,都可以刪掉。建立、join 和 expected 的輸出保持原本寫法,再用相同的 C11 與 -pthread 編譯指令建置。
atomic_fetch_add 會完成一次原子的讀取、增加、寫回,並回傳增加前的值。這裡只需要累加,所以沒有接住回傳值。
兩邊都增加一百萬次,正常完成後,結果一樣是兩百萬。這裡使用預設的循序一致性記憶體順序,先不另外調整 memory_order。C11 草案 N1570,第 7.17 節
不過,要保留的是整次原子更新。如果改成先 atomic_load,自己加 1,再 atomic_store,雖然讀與寫各自是原子的,中間仍然可能被插入另一邊的更新,一樣會遺失計數。
它修掉了前面的 data race,卻不代表自動修好所有依賴操作順序的邏輯。這也說明,race condition 和 C 裡的 data race,不能在每個情境都直接畫上等號。
原子操作,就一定完全沒有鎖嗎?
也不能這樣保證。
原子描述的是操作必須提供的語意。實際上可能使用硬體指令,也可能需要函式庫協助;不是每個型別、每個目標平台,都保證以無鎖方式完成。GCC 的原子介面也明確區分了可直接使用無鎖指令的情況,以及需要外部支援的情況。GCC:Atomic builtins
而且,即使不需要軟體鎖,兩顆核心一直搶同一個計數器,仍然會有協調與存取成本。不能把 atomic 理解成免費的加法。
它也不會自動把好幾個變數的更新合成一筆交易。像前面的庫存檢查,要用原子方式正確完成條件更新,還需要比較交換等方法,不能只替 stock 換個型別就當作全部處理好了。
這次先掌握單一計數器的原子累加。訊息發布、記憶體順序和無鎖資料結構,之後再拆。
2. 各算各的:最後才交換結果
回到最開始的需求。如果我們只是想知道兩邊最後總共加了多少次,有必要每一次都改同一個 counter 嗎?
好像不用。
可以讓 A 保存自己的總數,B 也保存自己的總數,兩邊都結束後,再由 main 相加。
這次的參數與結果,可以一起放進結構:
struct task {
    unsigned long iterations;
    unsigned long result;
};

static void *worker(void *arg) {
    struct task *task = arg;
    unsigned long local = 0;

    for (unsigned long i = 0; i < task->iterations; ++i) {
        local++;
    }
    task->result = local;
    return NULL;
}
沿用第四節的標頭檔和 check,保留 ITERATIONS 定義;移除全域的 counter、mutex,並把 main 換成:
int main(void) {
    pthread_t a, b;
    struct task tasks[2] = {
        { ITERATIONS, 0 },
        { ITERATIONS, 0 }
    };

    check(pthread_create(&a, NULL, worker, &tasks[0]), "create A");
    check(pthread_create(&b, NULL, worker, &tasks[1]), "create B");
    check(pthread_join(a, NULL), "join A");
    check(pthread_join(b, NULL), "join B");

    unsigned long total = tasks[0].result + tasks[1].result;
    printf("counter: %lu\n", total);
    printf("expected: %lu\n", 2UL * ITERATIONS);
    return 0;
}這裡兩條工作執行緒各自修改不同的結果欄位,main 則等 join 完才讀取。參數陣列在整段等待期間也都還存在。
所以,雖然它們仍然在同一個位址空間裡,卻沒有同時讀寫同一份計數。
編譯器可能把這種單純的區域累加迴圈,直接簡化成等效的結果。這是合理的最佳化,不必為了讓迴圈看起來「真的有跑」,又加上 volatile。也因此,不能拿這段空加法直接代表實際工作的平行效能。
如果換成每條執行緒各處理一部分資料,最後合併統計結果,重點也相同:先減少必須共享的更新,再考慮剩下的部分怎麼同步。
這種做法的取捨是,中途沒有一個每次都更新好的全域總數。如果需要即時進度、即時檢查上限,就要重新安排結果交換的頻率與規則。
九、接回 RP2350:兩顆核心一起做事
前面在 Linux 上,由作業系統管理 pthread。現在換回開發板,概念還能接上嗎?
可以,但使用的介面不同。
RP2350 支援雙核心執行,常見的 Pico 2 C 專案使用兩顆 Arm Cortex-M33 核心;晶片也提供 Hazard3 RISC-V 架構選項。這次聚焦在 Pico SDK 的一般雙核心用法。Raspberry Pi:RP2350 規格
在沒有另外加入 RTOS 的 Pico SDK 程式裡,不能直接把前面的 pthread_create 搬過來。可以讓 main 在 core 0 執行,再用:
multicore_launch_core1(core1_entry);讓 core 1 從 core1_entry 開始執行。這是在啟動第二顆核心的程式入口,不是建立一條由 Linux 排程的 pthread。Pico SDK:pico_multicore
而且,這裡沒有直接對應前面用法的 pthread_join。如果 core 0 需要知道對方做完了,就得另外安排同步通知。
兩邊可以存取同一份 SRAM 裡的全域資料。所以如果都對普通 counter 做讀改寫,共享更新的問題並不會因為換成微控制器就消失。
1. 用 critical_section 保護短時間的操作
Pico SDK 提供 critical_section_t,可以先初始化,再用同一份物件進出臨界區:
critical_section_enter_blocking(&counter_cs);
counter++;
critical_section_exit(&counter_cs);
這裡的臨界區不是只有一個名稱。SDK 的實作會使用 spinlock,並配合保存、停用呼叫端核心的中斷狀態,離開時再恢復。Pico SDK:critical_section.h
為什麼連中斷也要管?
因為共享資料的使用者,不一定只有另一顆核心。同一顆核心上的中斷處理程式,也可能在主程式更新一半時進來。
如果只拿了一把不可重入的自旋鎖,沒有處理這種中斷情境,中斷又試著取得同一把鎖,就可能一直等。被中斷的主程式卻要等中斷結束,才有機會回去解鎖。
反過來,只停用本核心的中斷,也不會讓另一顆核心一起停下來。因此,跨核心互斥和本核心的中斷保護,是要一起考慮的兩件事。
2. 讓兩顆核心各加十萬次
下面使用同一個臨界區物件保護 counter,也保護完成數量 finished。這樣 core 0 就能確認兩邊都完成,再輸出結果。
這是需要 RP2350 開發板與 Pico SDK 環境的 main.c,不能當成前面的桌面 C 程式編譯:
#include <stdio.h>
#include <stdint.h>
#include <inttypes.h>
#include "pico/stdlib.h"
#include "pico/multicore.h"
#include "pico/critical_section.h"

#define ITERATIONS 100000u

static critical_section_t counter_cs;
static uint32_t counter = 0;
static uint32_t finished = 0;

static void count_work(void) {
    for (uint32_t i = 0; i < ITERATIONS; ++i) {
        critical_section_enter_blocking(&counter_cs);
        counter++;
        critical_section_exit(&counter_cs);
    }

    critical_section_enter_blocking(&counter_cs);
    finished++;
    critical_section_exit(&counter_cs);
}

static void core1_entry(void) {
    count_work();
    while (true) {
        tight_loop_contents();
    }
}

int main(void) {
    stdio_init_all();
    critical_section_init(&counter_cs);
    multicore_launch_core1(core1_entry);

    count_work();

    uint32_t total;
    while (true) {
        critical_section_enter_blocking(&counter_cs);
        bool all_done = (finished == 2u);
        total = counter;
        critical_section_exit(&counter_cs);

        if (all_done) {
            break;
        }
        sleep_ms(1);
    }

    while (true) {
        printf("counter: %" PRIu32 ", expected: %u\n",
               total, 2u * ITERATIONS);
        sleep_ms(1000);
    }
}
初始化必須在啟動 core 1 之前完成。兩邊使用的是同一個 counter_cs,不是各自初始化一份自己的鎖。
finished 也不能隨便裸讀。否則 counter 雖然保護好了,等待完成的那個變數,卻又引入另一個未同步的共享存取。
這裡把「是否都完成」和「目前計數」一起讀到區域變數,再離開臨界區。後面的睡眠與輸出,都在鎖外。
core 1 做完後留在等待迴圈,不會再更新計數。core 0 確認完成後,則每秒重複印出同一份最終結果,方便連上序列埠觀察。
在 Pico SDK 專案裡,要連結哪些東西?
在已經準備好 Pico SDK、並呼叫 pico_sdk_init() 的專案中,可以加入:
add_executable(multicore_counter main.c)

target_link_libraries(multicore_counter
    pico_stdlib
    pico_multicore
    pico_sync
)

pico_enable_stdio_usb(multicore_counter 1)
pico_enable_stdio_uart(multicore_counter 0)
pico_add_extra_outputs(multicore_counter)
這不是完整的頂層 CMakeLists;SDK 的匯入、專案宣告與板型設定,仍然沿用原本的專案環境。使用 Pico 2 時,要選對應的 pico2 板型,再依原本的建置與燒錄流程操作。
開啟開發板的 USB 序列埠後,預期會每秒看到:
counter: 200000, expected: 200000這是依程式推導的預期結果。電腦端的 pthread 練習和這份板端程式,使用的是不同建置環境,不能共用前面的 cc ... -pthread 指令。
3. 這裡的臨界區,要比一般 mutex 更留意時間
前面說過,SDK 的 critical section 會停用呼叫端核心的中斷。因此,不只另一顆核心可能在等,這顆核心的中斷回應也可能受到影響。
所以臨界區裡只留短小、必要的共享存取。不要拿著它等待 USB 輸出、睡眠,或等待另一顆核心完成一大段工作。官方也明確把這個 API 定位在短時間的互斥操作。Pico SDK:critical_section
這個物件也不可重入。已經進入同一個臨界區,又呼叫一個內部會再次取得它的函式,可能把自己卡住。
至於 SDK 的 mutex_t,則是另一組介面。預設裸機環境會配合處理器事件等待與通知;Arm 上可透過 WFE/SEV 這類機制等待與喚醒,並不是 Linux 排程器把一條 pthread 掛起。它也不是這裡用來處理中斷存取的 critical section。Pico SDK:lock_core.h
所以,前面「spinlock 空轉、mutex 可以睡著等」的區別,到了實際平台,還是要看等待怎麼實作,以及能不能在目前的執行環境使用。
如果兩顆核心之間主要是在交付工作或結果,也可以考慮 Pico SDK 提供的安全佇列,讓資料透過明確的交接點傳遞。不是每一次分工,都得先設計成兩邊不停修改同一個變數。
十、先知道誰在改,再決定怎麼一起改
最開始只是想讓兩條執行緒各加一百萬次,看起來連公式都不用寫。
但一路拆下來,要先知道它們是不是在修改同一份資料,再看那次修改由哪些動作組成。如果兩邊都拿著舊值算,最後寫回去,另一邊的更新就可能不見。
鎖可以讓需要一起完成的操作依序進行;原子操作則替適合的單次更新提供不可分割的語意。如果最後才需要總數,讓大家先各自計算,反而能減少中途搶來搶去的必要。
所以我覺得,這次最重要的,不是看到共享變數就立刻加一把鎖。
而是先想清楚:誰會同時存取它、哪些動作必須一起完成,以及結果什麼時候才需要交給別人。
這些關係確定之後,再選 mutex、原子操作,或 Pico SDK 的 critical section,才比較知道自己到底保護了什麼。
至於加速,還得另外看工作怎麼分。兩顆核心都在等同一把鎖,確實很團結,但不見得有比較快。
先把共享更新弄清楚,後面再看佇列、通知與更完整的工作分配。前面 PIO 的資料要等誰、這次執行緒的鎖又被誰拿著,其實都得先把整條流程看見,才知道為什麼停在那裡。
參考資料
- Linux man-pages:pthread_create/pthread_join:建立執行緒、傳入參數與等待結束。
- POSIX:pthread_mutex_lock:互斥鎖的取得、釋放與阻塞語意。
- Linux man-pages:pthread_spin_lock:自旋等待及使用限制。
- Linux 核心:Mutex design:mutex 的快速取得、自旋與睡眠等待路徑;具體實作屬於 Linux 核心,不能直接當成 pthread 的實作規格。
- C11 草案 N1570:第 5.1.2.4 節的資料競爭與同步,以及第 7.17 節的原子操作。
- GCC:Volatiles/Atomic builtins:volatile 的限制,以及原子操作的目標平台支援。
- Raspberry Pi:Microcontroller chips:RP2350 的雙核心與架構選項。
- Pico SDK:High Level APIs:pico_multicore、critical_section、mutex 與佇列。
- Pico SDK:critical_section.h/lock_core.h:臨界區的 spinlock、中斷狀態與預設等待機制。
客官怎麼看
看完有話想說,留在這裡。罵我也可以,罵別人更好。
可用 GitHub 登入,或以筆名題字;Email 選填。地區章依網路位置辨識,臺灣可顯示縣市;編號用來區分留言。