DMA 直接記憶體存取
| 內容分類 | 學習筆記 |
|---|---|
| 筆記系列 | 計算機基礎 |
| 筆記篇幅 | 長篇筆記 |
| 學習狀態 | 複習與整理 |
| 本篇主題 | 搬運與交接 |
從不想讓 CPU 一筆一筆搬資料開始,理解 DMA 通道、傳輸筆數與寬度、位址遞增和對齊,再把設定、啟動、等待接到 PIO 的 DREQ 與雙緩衝。
前面已經知道,PIO 可以自己執行一小段程式,讓 CPU 不必每切換一次腳位,就親自去寫一次設定。
不過,資料還是要有人送進去。
如果每一筆都由 CPU 呼叫 pio_sm_put_blocking,等 FIFO 有空位,再把數字放進去,那 CPU 雖然不用管每個位元的時序,還是得一直回來補資料。
「都已經請 PIO 幫忙了,難道搬資料還是只能自己來?」
也不用。這次要看的,就是能不能先把來源、目的地和搬運方式交代好,再讓另一組硬體完成。
畢竟前一篇才說,兩顆核心都在等同一把鎖,不見得比較快。這次先看看,有些工作是不是連核心都不用一直陪著做。
一、DMA 是什麼?
DMA 是 Direct Memory Access,也就是直接記憶體存取。
先用最簡單的需求來看:把陣列 src 的四個數字,複製到另一個陣列 dst。
如果交給 CPU,可以寫成:
for (unsigned int i = 0; i < 4; ++i) {
    dst[i] = src[i];
}
這段是在說明要完成的事情。實際編譯時,編譯器可能調整成別的等效寫法,但讀取來源、寫入目的地的工作,仍然是由 CPU 執行。
DMA 則是晶片裡專門協助資料傳輸的硬體。CPU 先設定好這次要怎麼搬,再啟動 DMA,讓它透過晶片內的匯流排讀寫資料。
這裡的匯流排(Bus),先理解成處理器、記憶體與周邊之間傳遞讀寫要求和資料的通路就好。
搬運開始之後,CPU 就不必替每一筆資料執行一次複製,可以去做別的工作。
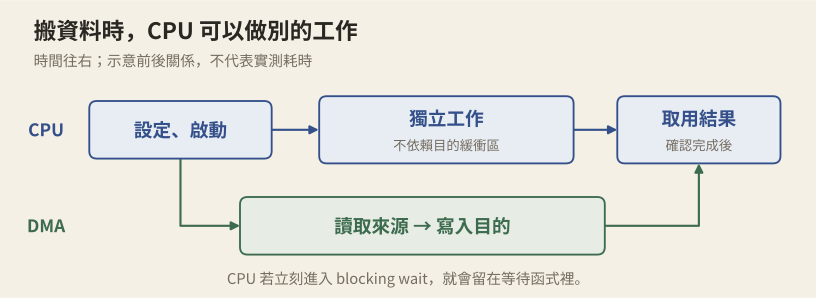
除了記憶體之間的複製,也可以從記憶體搬到周邊,或從周邊搬回記憶體。例如把陣列裡的資料送進 PIO TX FIFO,或把 PIO RX FIFO 裡的結果收進陣列。RP2040 資料手冊,第 2.5 節
不過,這裡的「CPU 空出來」,是指它不用一直執行搬運指令,不代表 DMA 完全不使用其他資源。
CPU 和 DMA 都可能需要存取記憶體,也會共用部分傳輸資源。因此,能讓工作重疊,不等於原本的計算一定完全不受影響,更不保證每次複製都值得改成 DMA。
而且,這次使用 DMA 做的是搬運。它不會看到陣列,就順便替我們把數字排序或算好平均值。後面的計算,仍然要自己安排。
這篇使用 Pico SDK 的 C 介面,以 RP2040 和 RP2350 都能使用的基本、有限筆數傳輸為主。程式需要開發板與對應的 SDK 建置環境,不能當成一般桌面 C 程式直接執行。
二、開始搬之前,先取得一個通道
同一顆晶片裡,可能不只一件事情想使用 DMA。
例如一邊替 PIO 送資料,另一邊又想接收 ADC 的取樣結果。這些傳輸各有自己的來源、目的地和進度,總不能混在同一份設定裡。
所以,DMA 提供通道(Channel),讓我們分別安排傳輸。
每個通道有自己的控制與狀態暫存器,可以保存「現在讀到哪裡、寫到哪裡、還剩多少筆」。但多個通道仍然會分享 DMA 的傳輸資源,不是每多一個通道,就多出一整套獨立頻寬。
1. 通道有幾個?
數量要看晶片:
| 晶片 | DMA 通道數量 |
|---|---|
| RP2040 | 12 個 |
| RP2350 | 16 個 |
RP2040 的數量可對照資料手冊,RP2350 則可對照 SDK 的 NUM_DMA_CHANNELS 定義。不能看到前一篇用 RP2350,這次又提到 RP2040,就把兩邊的容量當成一樣。
2. Claim:先登記自己要使用
在 Pico SDK 裡,可以請它找一個尚未被使用的通道:
int ch = dma_claim_unused_channel(true);ch 保存取得的通道編號。最後的 true 表示這次一定需要一個,如果沒有可用通道,就觸發 panic,讓程式明確失敗,不會排隊等別人歸還。
如果想自行處理沒有通道的情況,可以傳入 false,並檢查是否回傳 -1。Pico SDK:DMA 通道 API
這裡的 claim,可以先理解成 SDK 裡的使用登記。它讓同樣遵守這套機制的程式與函式庫,不會不小心挑到同一個通道。
它不是替來源陣列加鎖,也不是讓 DMA 立刻開始搬資料。現在只取得一個可以設定的通道。
3. 用完後,要還回去
當這個通道的工作都完成,而且確定不再使用時:
dma_channel_unclaim(ch);這就是這裡說的 release,Pico SDK 的函式名稱使用 unclaim。
不過,unclaim 只解除使用登記,不會替我們等待傳輸結束,也不會自動取消仍在進行的搬運。 可以直接從 SDK 的實作看到,它處理的是 claim 紀錄。
所以這篇的順序會是:先取得通道,設定與啟動,確認完成,最後才歸還。
同一個功能如果要反覆傳輸,也可以持有通道並重新設定,不需要每搬一筆就 claim、unclaim 一次。
三、要交代哪些事情,DMA 才知道怎麼搬?
假設準備好兩個陣列:
static uint32_t src[4] = { 0x1Au, 0x80u, 0x05u, 0xFFu };
static uint32_t dst[4] = { 0 };
這裡的 uint32_t 是 32 位元無號整數,在本篇使用的環境裡,每個元素占四個位元組。src 是來源,dst 則是準備接收結果的空間。
「把這四個數字複製過去」,人看得懂,但 DMA 還需要更具體的設定。
| 要設定的事情 | 常見名稱 | 這次的安排 |
|---|---|---|
| 從哪裡讀 | source/src | src 的起始位址 |
| 寫到哪裡 | destination/dst | dst 的起始位址 |
| 搬幾筆 | count | 4 筆 |
| 每筆多寬 | transfer size | 4 位元組,也就是 32 位元 |
| 每讀完一筆,來源位址要不要往前 | read increment | 要 |
| 每寫完一筆,目的位址要不要往前 | write increment | 要 |
最後兩項分開設定,後面就會看到,這個差別不只影響陣列複製,也能用來填值和存取 FIFO。
1. Count 是筆數,不是位元組數
先把最容易弄錯的地方拆開。
這次有四筆,每筆四個位元組,所以總共搬:
4 筆 × 每筆 4 位元組 = 16 位元組因此,count 要填 4,不是 16。
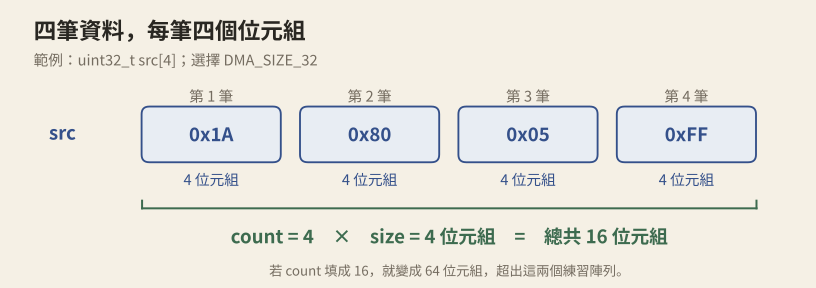
如果 size 已經設成四位元組,卻把 count 填成 16,DMA 就會嘗試搬 16 筆,也就是 64 位元組。這兩個陣列明明都只有 16 位元組,搬運就超出範圍了。
DMA 不知道 C 陣列原本宣告多長,不會替我們在第四個元素後面自動停下來。
這也解釋了,為什麼不能看到 sizeof(src) 就直接填進 count。sizeof(src) 在這裡得到的是 16,代表整個陣列占多少位元組。
如果想取得元素數量,可以使用 SDK 的 count_of(src),或寫成:
sizeof(src) / sizeof(src[0])這次剛好是每筆搬一個完整元素,所以元素數量才和傳輸筆數相同。若改成每筆只搬一個位元組,count 也要重新計算。
另外,這種計算要用在仍然是陣列的地方。函式參數裡的 uint32_t *src 只是指標,sizeof(src) 不會找出它背後有幾個元素。
2. Size:一筆是 1、2,還是 4 個位元組?
這篇使用的基本傳輸寬度有三種:
| 每筆寬度 | 位元數 | SDK 設定 |
|---|---|---|
| 1 位元組 | 8 bits | DMA_SIZE_8 |
| 2 位元組 | 16 bits | DMA_SIZE_16 |
| 4 位元組 | 32 bits | DMA_SIZE_32 |
注意名稱裡的 8、16、32 是位元數,不是位元組數。這些名稱也不是直接填入數值 1、2、4 的意思,要使用對應的列舉常數。
以目前的陣列來說,我們選 DMA_SIZE_32,每次讀取一個完整的 uint32_t,再寫入另一邊。
DMA 不會根據 src 的 C 型別,自動替我們選好 size;型別、設定與空間大小,要自己對起來。Pico SDK:DMA 設定與傳輸筆數
四、Increment:搬完一筆,下一筆在哪裡?
先只看複製陣列。
假設來源起點是 0x20000000,目的起點是 0x20000100,每筆四位元組,而且兩邊都開啟 increment:
| 第幾筆 | 讀取位址 | 寫入位址 | 搬到的內容 |
|---|---|---|---|
| 1 | 0x20000000 | 0x20000100 | 0x0000001A |
| 2 | 0x20000004 | 0x20000104 | 0x00000080 |
| 3 | 0x20000008 | 0x20000108 | 0x00000005 |
| 4 | 0x2000000C | 0x2000010C | 0x000000FF |
這些位址只用來示意間距。真正的程式會把陣列的位址交給 SDK,不需要自己把它安排到上面這兩個位置。
每搬一筆,兩邊都往後四個位元組,才會依序走到下一個元素。
所以,increment 不是永遠加 1,而是依照這次的 transfer size,增加對應的位元組數。
那如果來源不往前走呢?
DMA 就會每次讀同一個位置。如果那裡一直放著 0x0000001A,目的位址卻繼續往前,就能把四個元素都填成 0x0000001A。
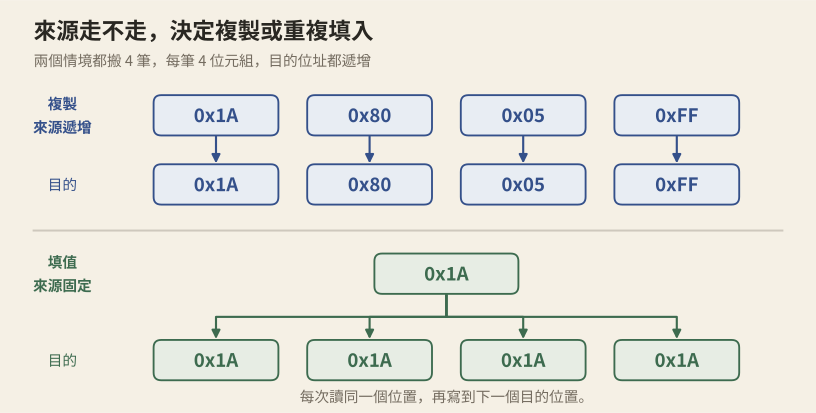
因此,複製和填值不需要兩套完全不同的搬運原理。關鍵是下一次讀取,還留在原處,還是移到下一個元素。
但目的位址如果也不動,就只會反覆寫同一個位置,不會自動填滿整個陣列。每一邊的 increment,都要分開確認。
五、對齊:位址有了,還要看能不能這樣讀寫
知道每次搬四個位元組後,還有一個條件:來源和目的位址,都必須符合這次傳輸寬度的對齊要求。
在這篇使用的 DMA 裡,起始位址要是 size 的倍數:
| 每筆寬度 | 起始位址的要求 | 示意 |
|---|---|---|
| 1 位元組 | 位元組對齊 | 0x20000001 也符合 |
| 2 位元組 | 2 的倍數 | 0x20000002 符合,0x20000003 不符合 |
| 4 位元組 | 4 的倍數 | 0x20000004 符合,0x20000002 不符合 |
例如 0x20000004 除以 4 沒有餘數,就符合四位元組對齊。這是在看位址,不是要求裡面的數值也得是 4 的倍數。0x1A 當然還是可以搬。
前面的 uint32_t src[4] 和 dst[4],在本篇的 Pico SDK 目標環境裡,會有合適的四位元組對齊,而且每個元素也正好相隔四個位元組。
但如果改成一個位元組陣列,再從 bytes + 1 開始,就不能直接假設仍然符合四位元組要求。
把指標強制轉成 uint32_t *,也不會把原本的位址搬到別處。轉型改變的是程式怎麼看待那個位址,對齊仍然要看位址本身。 RP2040:DMA 位址設定,第 2.5.1.1 節
對周邊還要再多看一件事:那個暫存器允許多寬的存取。位址對齊,只代表符合其中一個條件,不代表任何周邊都可以任選 1、2、4 位元組讀寫。
六、設定、啟動、等待,再取用結果
現在把前面的設定交給 Pico SDK。
一次傳輸可以先拆成四個階段:
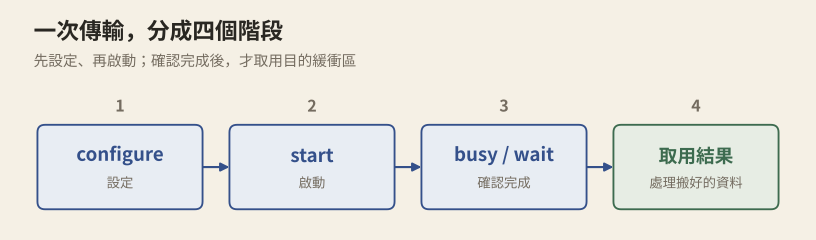
重點是前後順序。設定完成、開始搬運,以及搬運完成,是不同的時間點。
1. Configure:先把安排寫好
取得通道後,先拿到一份預設設定,再修改需要的項目:
dma_channel_config c = dma_channel_get_default_config(ch);
channel_config_set_transfer_data_size(&c, DMA_SIZE_32);
channel_config_set_read_increment(&c, true);
channel_config_set_write_increment(&c, true);
channel_config_set_dreq(&c, DREQ_FORCE);
前面三項,分別接上每筆四位元組、來源往前走、目的也往前走。
最後的 DREQ_FORCE,表示這次不等周邊的資料請求節奏,有可用的傳輸資源就繼續搬。先用在記憶體之間的複製,DREQ 接到 PIO 時再細看。
c 現在只是 CPU 準備的一份設定物件。接著才把它和兩邊的位址、筆數,一起套用到通道:
dma_channel_configure(ch, &c, dst, src, 4, false);這一行很值得多看一眼。
我們平常說「從 src 搬到 dst」,但函式的順序是:
dma_channel_configure(ch, &c, dst, src, count, start)dst 寫在 src 前面。 也就是先交代寫入位址,再交代讀取位址。
把參數完整對上:
| 參數 | 這次的意思 |
|---|---|
ch | 使用哪個通道 |
&c | 使用剛才準備好的設定 |
dst | 寫入目的陣列 |
src | 讀取來源陣列 |
4 | 搬四筆,每筆寬度由 c 決定 |
false | 現在只設定,不立刻啟動 |
這裡的 start 是為了方便理解而取的名字,SDK 介面的參數名稱是 trigger。意思都是這次設定後,是否立即觸發傳輸。Pico SDK:dma_channel_configure
2. Start:現在才開始搬
因為前面傳入 false,可以再明確啟動:
dma_start_channel_mask(1u << ch);這是不是接回位元運算了?
1u << ch 準備的是通道選取遮罩,只有 bit ch 是 1。這一位選中的,是 DMA 通道,不是來源資料裡的某個位元。
如果前面的 configure 最後直接傳 true,就會在設定後立即啟動,不需要再執行一次 start。這次刻意分開,是為了看清楚兩個階段。
3. Busy/wait:要知道它做完了沒有
想查目前是否仍在搬運,可以用:
bool busy = dma_channel_is_busy(ch);true 表示通道仍然忙碌。CPU 可以先做其他獨立工作,之後再回來確認。
不過,還沒啟動的通道也可能是不忙碌的。所以要先確定這次傳輸已經啟動,再用 busy 判斷進度,不能看到 false 就認為資料一定搬好了。
如果接下來一定需要整份結果,就可以等待:
dma_channel_wait_for_finish_blocking(ch);但這裡有一個很容易想錯的地方:
「前面不是才說,DMA 會讓 CPU 空出來嗎?」
是,搬運本身不必由 CPU 逐筆執行。但如果 CPU 啟動後,立刻呼叫 blocking wait,它就會留在這個函式裡等,還沒有利用那段時間去做其他工作。
SDK 的這個函式會反覆檢查 busy,完成後才回傳;它不會自動替我們安排另一份工作,也沒有內建逾時。Pico SDK:DMA 等待函式實作
第一次練習先這樣寫,容易確認順序。後面談雙緩衝時,才把 CPU 的工作放進這段空檔。
4. 取用結果:等到完成,再讀目的陣列
正常完成後,才從 dst 取用這次搬好的四筆資料。
不能因為 start 已經回傳,就直接把整個 dst 當成新結果。DMA 可能還在搬,中間的陣列也可能只有一部分更新完成。
同樣地,搬運期間也不能隨意改寫 DMA 正在讀的來源。否則這次拿到的,可能前半段來自修改前,後半段來自修改後。
所以要一起安排的,是來源什麼時候可以再改、目的什麼時候可以開始讀,以及兩份空間要保留到什麼時候。
七、實際把四筆數字複製一次
把剛才的主線放在一起,建立 main.c:
#include <stdio.h>
#include <stdint.h>
#include <inttypes.h>
#include "pico/stdlib.h"
#include "hardware/dma.h"

static uint32_t src[4] = { 0x1Au, 0x80u, 0x05u, 0xFFu };
static uint32_t dst[4] = { 0 };

int main(void) {
    stdio_init_all();

    int ch = dma_claim_unused_channel(true);
    dma_channel_config c = dma_channel_get_default_config(ch);
    channel_config_set_transfer_data_size(&c, DMA_SIZE_32);
    channel_config_set_read_increment(&c, true);
    channel_config_set_write_increment(&c, true);
    channel_config_set_dreq(&c, DREQ_FORCE);

    dma_channel_configure(ch, &c, dst, src, count_of(src), false);
    dma_start_channel_mask(1u << ch);

    dma_channel_wait_for_finish_blocking(ch);
    dma_channel_unclaim(ch);

    while (true) {
        for (uint i = 0; i < count_of(dst); ++i) {
            printf("dst[%u]: 0x%08" PRIX32 "\n", i, dst[i]);
        }
        sleep_ms(1000);
    }
}
這裡的來源和目的都使用靜態陣列,整個傳輸期間一直存在,而且是兩塊互不重疊的空間。
程式只搬一次。後面的迴圈每秒重複輸出同一份完成的結果,方便連上 USB 序列埠查看;不是每次輸出前又重新複製。
預期看到:
dst[0]: 0x0000001A
dst[1]: 0x00000080
dst[2]: 0x00000005
dst[3]: 0x000000FF
四個數字沒變,只是被放到另一份空間。和前一篇的共享變數一樣,內容相同,不代表它們是同一個物件。
在 Pico SDK 專案裡,要連結哪些東西?
在已經準備好 Pico SDK、並呼叫 pico_sdk_init() 的專案中,加入:
add_executable(dma_copy main.c)

target_link_libraries(dma_copy
    pico_stdlib
    hardware_dma
)

pico_enable_stdio_usb(dma_copy 1)
pico_enable_stdio_uart(dma_copy 0)
pico_add_extra_outputs(dma_copy)
這不是完整的頂層 CMakeLists。SDK 匯入、專案宣告與板型設定,仍然使用原本的專案環境。RP2040 的 Pico 和 RP2350 的 Pico 2,要選擇各自對應的板型,再依原本流程建置、燒錄。
這個練習沒有使用 GPIO,不需要額外接線。
看到 DMA,就得把陣列全部加上 volatile 嗎?
先回到前兩篇的區別:volatile 處理的是編譯器如何看待存取,不會替我們決定資料何時可以交接。
這裡使用 SDK 的啟動與完成等待介面。完成等待函式除了檢查硬體狀態,也包含編譯器記憶體屏障,避免後面的普通緩衝區讀取被提到完成檢查之前。
編譯器記憶體屏障可以先理解成,限制編譯器把相關記憶體存取移過這個位置。它和讓 DMA 完成搬運,是不同的事情;等待函式把兩邊需要的工作接起來。
因此,這支程式不需要把兩個陣列全部改成 volatile。但也不能刪掉完成等待,只因為陣列加了 volatile,就提前讀取結果。
這段說明限定在本篇的 Pico SDK 與一般 SRAM 緩衝區。換成有資料快取、不同記憶體區域,或自行實作中斷與多核心交接時,還要遵守目標平台的同步與快取規則。
八、只改來源的走法,就能改成填值
現在把需求換成:讓四個目的元素,都得到 0x0000001A。
先保留第七節的陣列、通道取得與後面的等待、輸出,只把來源遞增改成:
channel_config_set_read_increment(&c, false);其他條件相同:每筆四位元組,目的位址繼續遞增,count 仍然是 4。
因為 src 的第一個元素正好是 0x1A,這次會反覆讀取 src[0],再依序寫進 dst[0] 到 dst[3]。
重新建置、燒錄後,預期輸出就變成:
dst[0]: 0x0000001A
dst[1]: 0x0000001A
dst[2]: 0x0000001A
dst[3]: 0x0000001A
欸,明明沒有另外設定「填滿」,它卻真的填滿了。
因為 DMA 每次仍然在做讀取、寫入,只是讀取位址一直留在同一個地方。這也說明,填值不是把 count 改成 1;如果只有一筆,就只會寫一個目的位置。
實際上不需要為了填值保留整個來源陣列,也可以準備一個單獨的值:
static uint32_t fill_value = 0x0000001Au;

/* c 已設定 32 位元、來源不遞增、目的遞增。 */
dma_channel_configure(ch, &c, dst, &fill_value, count_of(dst), false);
這是來源寫法的替換片段,要放在通道仍由自己持有、而且沒有傳輸正在執行的時候,再接上 start 和完成等待。
注意來源要傳 &fill_value,也就是存放這個值的位址,不是直接把 0x1A 當成來源參數。DMA 需要知道去哪裡讀,而不是只拿到我們想填的數字。
如果改用區域變數,也必須確保 DMA 完成前,它還在作用範圍內,而且內容沒有被修改。函式先 return,把堆疊上的值留給 DMA 慢慢讀,並不會讓那份資料自動延長壽命。
另外,這次填的是完整的 32 位元圖樣,和 memset(dst, 0x1A, sizeof(dst)) 不一樣。memset 會逐位元組填入 0x1A,每個 uint32_t 就會得到 0x1A1A1A1A。
都是「填值」,還是要看一筆多寬。
九、接到 PIO:DMA 怎麼知道 FIFO 現在能不能放?
前面的來源和目的都是記憶體。接下來終於可以回到最開始的問題:把陣列裡的資料交給 PIO。
方向變成:
- 來源陣列
- DMA
- TX FIFOPIO 的資料佇列
- OSR
- PIO執行後續操作
我們已經知道,TX FIFO 的容量有限。如果 DMA 不管裡面還有沒有位置,就一直寫,當然不能期待第五筆會自己排在 FIFO 外面。
這時候就需要 DREQ(Data Request,資料請求)。
1. DREQ:讓周邊參與決定搬運的節奏
DREQ 是周邊提供給 DMA 的請求機制,讓傳輸配合周邊的需求。
以 PIO TX 來說,FIFO 有可用空間時,DMA 才依照請求補資料;FIFO 滿了,就得等 PIO 取走,騰出位置再繼續。
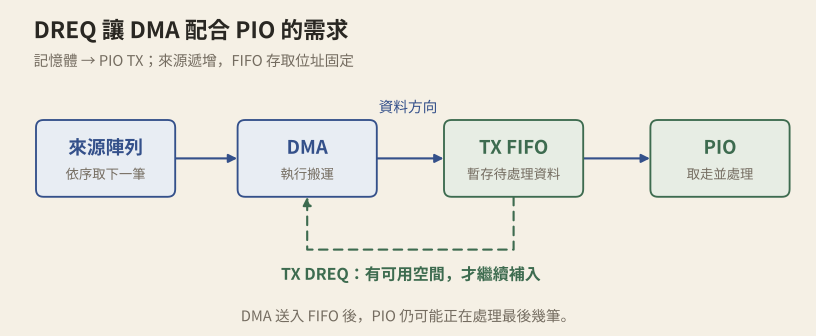
這不是 CPU 一直檢查 FIFO,再通知 DMA 可以搬。相關請求由周邊硬體與 DMA 配合,不需要每筆都讓 CPU 回來處理。RP2040:DREQ,第 2.5.3 節
不過,DREQ 決定的是周邊這一端何時允許傳輸,不會替我們準備來源資料,也不會檢查來源陣列是否還活著。
2. 來源往前走,FIFO 位址留在原處
假設 pio 和 sm 已經選好,PIO 程式也已載入、初始化,會持續取走 TX FIFO 的資料。可以這樣設定 DMA:
dma_channel_config c = dma_channel_get_default_config(ch);
channel_config_set_transfer_data_size(&c, DMA_SIZE_32);
channel_config_set_read_increment(&c, true);
channel_config_set_write_increment(&c, false);
channel_config_set_dreq(&c, pio_get_dreq(pio, sm, true));

dma_channel_configure(ch, &c, &pio->txf[sm], src, count_of(src), false);
dma_start_channel_mask(1u << ch);
這是設定片段,還沒有列出整份 PIO 專案。先看和陣列複製相比,改了什麼。
來源仍然遞增,因為要依序讀 src[0]、src[1]。目的則關閉遞增,因為每一筆都要寫進同一個 FIFO 存取暫存器。
&pio->txf[sm] 就是這個狀態機 TX FIFO 的寫入位置。
「寫同一個位址,不會一直蓋掉上一筆嗎?」
如果是普通變數,會。但這個位址對應的是 FIFO 介面,每次有效寫入,硬體會把資料放進佇列。這就接回位元運算那篇說的:同樣是寫入,會發生什麼,要看那個位置的硬體定義。
所以不能讓目的位址每次加 4,以為這樣才是在填下一格 FIFO。那會走到別的硬體位置。
最後的 pio_get_dreq(pio, sm, true),取得的是這個狀態機的 TX DREQ。這裡的 true 表示送進 PIO;若是從 RX FIFO 收回資料,則使用 false。Pico SDK:pio_get_dreq
把兩個方向對起來:
| 方向 | 來源位址 | 目的位址 | 來源遞增 | 目的遞增 | DREQ |
|---|---|---|---|---|---|
| 記憶體 → PIO TX | 陣列 | &pio->txf[sm] | 是 | 否 | pio_get_dreq(pio, sm, true) |
| PIO RX → 記憶體 | &pio->rxf[sm] | 陣列 | 否 | 是 | pio_get_dreq(pio, sm, false) |
我們這裡都使用 32 位元存取,配合 FIFO 每筆 32 位元的資料。它不是看到來源只有低八位有用,就自動把 count 或 FIFO 寬度一起改掉。
3. DMA 完成,不等於腳位已經全部送完
還記得 PIO 那篇的 put 嗎?資料排進 TX FIFO,和狀態機完成處理,是不同時間點。
換成 DMA 也一樣。
TX DMA 完成,表示這批資料已經搬到 TX FIFO;其中最後幾筆,仍可能留在 FIFO 或 OSR 裡,等待 PIO 繼續處理。
因此,等 DMA 結束後,可以安排重用它已讀完的來源緩衝區。但如果要停止 PIO、改腳位功能,或通知外部裝置整份訊息已送完,就還要確認 PIO 與協定自己的完成條件。
單看 FIFO 已空,也未必夠,因為 OSR 可能還在輸出。這個區別在後面做連續傳輸時,會很有用。
4. 前一篇的往返練習,也要有人讀 RX
如果沿用 PIO 那篇「取出一筆,再送回一筆」的程式,只安排 TX DMA,不安排 RX 的接收,會怎樣?
前幾筆可能正常,但 RX FIFO 最後會滿。PIO 卡在 push block,不能再取新的 TX 資料,TX FIFO 也會慢慢滿起來。
於是 DMA 雖然還有來源資料,卻等不到更多 TX 的傳輸機會。CPU 如果只是在等 TX DMA 完成,整條流程仍然可能互相等待。
把 CPU 的搬運換成 DMA,沒有順便消除另一端必須有人接收的需求。
用兩個 DMA 通道,讓八筆資料經過 PIO 再回來
這是另一個獨立練習。它沿用前一篇的四條指令,關閉 autopull、autopush,不使用 GPIO。
建立 dma-echo.pio:
.program dma_echo

.wrap_target
    pull block
    out x, 32
    in x, 32
    push block
.wrap
把 main.c 換成下面這份:
#include <stdio.h>
#include <stdint.h>
#include <inttypes.h>
#include "pico/stdlib.h"
#include "hardware/dma.h"
#include "hardware/pio.h"
#include "dma-echo.pio.h"

static uint32_t src[8] = {
    0x1Au, 0x80u, 0x05u, 0xFFu, 1u, 2u, 3u, 4u
};
static uint32_t dst[8] = { 0 };

int main(void) {
    stdio_init_all();

    PIO pio = pio0;
    uint sm = pio_claim_unused_sm(pio, true);
    uint offset = pio_add_program(pio, &dma_echo_program);
    pio_sm_config pc = dma_echo_program_get_default_config(offset);
    sm_config_set_out_shift(&pc, true, false, 32);
    sm_config_set_in_shift(&pc, true, false, 32);
    sm_config_set_fifo_join(&pc, PIO_FIFO_JOIN_NONE);
    pio_sm_init(pio, sm, offset, &pc);

    int tx_ch = dma_claim_unused_channel(true);
    int rx_ch = dma_claim_unused_channel(true);

    dma_channel_config tx = dma_channel_get_default_config(tx_ch);
    channel_config_set_transfer_data_size(&tx, DMA_SIZE_32);
    channel_config_set_read_increment(&tx, true);
    channel_config_set_write_increment(&tx, false);
    channel_config_set_dreq(&tx, pio_get_dreq(pio, sm, true));

    dma_channel_config rx = dma_channel_get_default_config(rx_ch);
    channel_config_set_transfer_data_size(&rx, DMA_SIZE_32);
    channel_config_set_read_increment(&rx, false);
    channel_config_set_write_increment(&rx, true);
    channel_config_set_dreq(&rx, pio_get_dreq(pio, sm, false));

    dma_channel_configure(rx_ch, &rx, dst, &pio->rxf[sm],
                          count_of(dst), false);
    dma_channel_configure(tx_ch, &tx, &pio->txf[sm], src,
                          count_of(src), false);

    dma_start_channel_mask((1u << rx_ch) | (1u << tx_ch));
    pio_sm_set_enabled(pio, sm, true);

    dma_channel_wait_for_finish_blocking(tx_ch);
    dma_channel_wait_for_finish_blocking(rx_ch);

    dma_channel_unclaim(tx_ch);
    dma_channel_unclaim(rx_ch);
    pio_sm_set_enabled(pio, sm, false);
    pio_remove_program(pio, &dma_echo_program, offset);
    pio_sm_unclaim(pio, sm);

    while (true) {
        for (uint i = 0; i < count_of(dst); ++i) {
            printf("%u: 0x%08" PRIX32 " -> 0x%08" PRIX32 "\n",
                   i, src[i], dst[i]);
        }
        sleep_ms(1000);
    }
}
在已呼叫 pico_sdk_init() 的專案裡,使用這組目標設定,取代前面單純複製的目標:
add_executable(dma_pio_echo main.c)
pico_generate_pio_header(dma_pio_echo
    ${CMAKE_CURRENT_LIST_DIR}/dma-echo.pio
)
target_link_libraries(dma_pio_echo
    pico_stdlib
    hardware_dma
    hardware_pio
)
pico_enable_stdio_usb(dma_pio_echo 1)
pico_enable_stdio_uart(dma_pio_echo 0)
pico_add_extra_outputs(dma_pio_echo)
預期每組輸出有八行,左右相同:
0: 0x0000001A -> 0x0000001A
1: 0x00000080 -> 0x00000080
2: 0x00000005 -> 0x00000005
3: 0x000000FF -> 0x000000FF
4: 0x00000001 -> 0x00000001
5: 0x00000002 -> 0x00000002
6: 0x00000003 -> 0x00000003
7: 0x00000004 -> 0x00000004
這裡刻意搬八筆,超過預設單邊 FIFO 的四筆容量。兩個 DMA 通道會隨著各自的 DREQ,持續服務傳送和接收,不需要讓 FIFO 一次放下全部八筆。
兩邊都設定好、啟動之後,才讓 PIO 開始跑。CPU 雖然先等待 TX,但 RX DMA 已經在運作,不是等 TX 全送完才開始接收。
而且我們最後也等 RX DMA 完成,才讀 dst。這確認的是八筆結果已搬回記憶體,和單獨等 TX 完成的意義不同。
這個往返仍然只在晶片內部搬數字,不能拿它的完成時間,當成某個外部通訊協定已經送完的證明。
十、雙緩衝:它搬這一塊,我處理另一塊
前面已經能讓 DMA 自己搬,也知道要等到完成才讀取結果。
但如果程式一直是:
- 搬第 0 塊等待 DMA 完成
- 處理第 0 塊CPU 計算
- 搬第 1 塊等待 DMA 完成
- 處理第 1 塊CPU 計算
那搬運和計算,還是被排成前後兩段。
「既然 CPU 可以做別的事,能不能在下一塊搬進來的時候,先算上一塊?」
可以,這就會用到雙緩衝(Double Buffering),也常叫做 ping-pong。
1. 先準備 A、B 兩塊空間
假設 DMA 要持續把資料搬進記憶體,CPU 則負責處理搬好的內容。
我們先準備 A、B 兩個緩衝區,依序安排:
| 階段 | DMA 在做什麼 | CPU 在做什麼 |
|---|---|---|
| 起步 | 把第 0 塊搬到 A | 還沒有完成的區塊可處理 |
| 第一次交接 | 把第 1 塊搬到 B | 處理 A 裡的第 0 塊 |
| 第二次交接 | 把第 2 塊搬到 A | 處理 B 裡的第 1 塊 |
| 繼續交替 | 搬下一塊到已釋放的緩衝區 | 處理另一塊已搬好的資料 |
| 最後收尾 | 不再啟動新傳輸 | 處理最後一塊 |
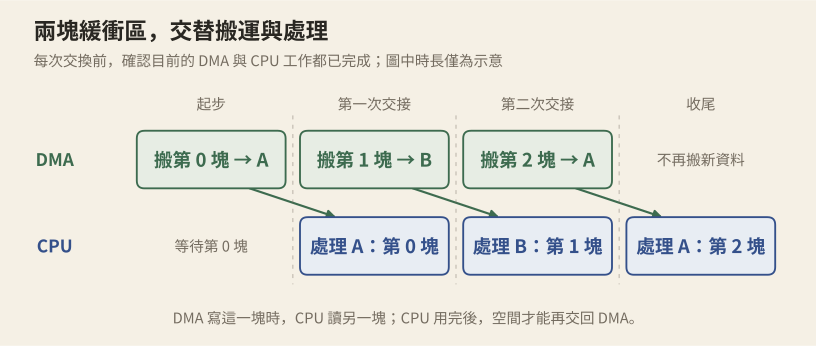
重點不是名字叫 A 還是 B,而是DMA 正在寫的那一塊,CPU 還不拿來當成完成資料;CPU 還在讀的那一塊,也不能交回去讓 DMA 覆寫。
兩塊空間,就是讓雙方可以暫時各用一塊。
2. 每次交棒,都要確認誰已經用完
先把接收方向的規則寫清楚:
- 空閒可以交給 DMA
- DMA 寫入等搬運完成
- CPU 處理等處理結束
- 歸還空間回到空閒,再交下一輪
這不是光切換一個 index ^= 1 就全部完成了。索引只是在選 A 或 B,資料是否可用,還是要靠完成狀態來判斷。
如果 CPU 算得比較久,DMA 不能只因為下一輪輪到 A,就把 CPU 還沒讀完的內容蓋掉。
反過來,如果 DMA 還沒搬好,CPU 也不能因為自己已經閒下來,就先讀半份結果。
這是不是又接回執行緒那篇了?先知道誰在用同一份資料,再安排交接;只是這次其中一方,換成 DMA 硬體。
不用中斷,先用三塊記憶體資料練習交替處理
這個練習不接周邊,來源是三塊已準備好的記憶體資料。DMA 依序把它們搬進兩個緩衝區,CPU 則計算每塊的總和。
把第七節的 main.c 換成:
#include <stdio.h>
#include <stdint.h>
#include "pico/stdlib.h"
#include "hardware/dma.h"

#define BLOCK_COUNT 3u
#define BLOCK_WORDS 4u

static uint32_t input[BLOCK_COUNT][BLOCK_WORDS] = {
    { 1u, 2u, 3u, 4u },
    { 5u, 6u, 7u, 8u },
    { 9u, 10u, 11u, 12u }
};
static uint32_t buffers[2][BLOCK_WORDS];

static unsigned long sum_block(const uint32_t *data) {
    unsigned long sum = 0;
    for (uint i = 0; i < BLOCK_WORDS; ++i) {
        sum += data[i];
    }
    return sum;
}

int main(void) {
    stdio_init_all();

    int ch = dma_claim_unused_channel(true);
    dma_channel_config c = dma_channel_get_default_config(ch);
    channel_config_set_transfer_data_size(&c, DMA_SIZE_32);
    channel_config_set_read_increment(&c, true);
    channel_config_set_write_increment(&c, true);
    channel_config_set_dreq(&c, DREQ_FORCE);

    uint current = 0;
    unsigned long total = 0;
    dma_channel_configure(ch, &c, buffers[current], input[0],
                          BLOCK_WORDS, true);

    for (uint block = 0; block < BLOCK_COUNT; ++block) {
        dma_channel_wait_for_finish_blocking(ch);

        uint next = current ^ 1u;
        if (block + 1u < BLOCK_COUNT) {
            dma_channel_configure(ch, &c, buffers[next], input[block + 1u],
                                  BLOCK_WORDS, true);
        }

        total += sum_block(buffers[current]);
        current = next;
    }

    dma_channel_unclaim(ch);

    while (true) {
        printf("total: %lu, expected: 78\n", total);
        sleep_ms(1000);
    }
}
沿用第七節的 CMake 目標即可。正常完成時,預期每秒看到:
total: 78, expected: 78最前面先把第 0 塊搬到 A。進入迴圈後,先等目前這塊完成,再啟動下一塊往 B 的搬運,最後才計算 A。
下一輪要把第 2 塊搬回 A 時,上一輪對 A 的加總已經結束,所以不會覆寫 CPU 還在使用的內容。
最後一輪沒有下一塊,就只處理剩下的緩衝區,不再啟動新傳輸。這個收尾也要安排,不能只寫一個永遠切換的索引。
每次重新 configure,都有提供新的來源起點、目的起點與筆數。前一段 DMA 的位址已經往前走,不能只再 start 一次,就假設它會自動回到陣列開頭。
這裡的兩個緩衝區只用了一個 DMA 通道,由 CPU 在每塊完成後重新設定。雙緩衝指的是兩份資料空間,不是一定要有兩個通道。
四個數字的加總很快,DMA 也可能在 CPU 開始計算前就已完成。這支程式用來確認交接順序,沒有拿它測量加速效果。
3. 有兩塊,就一定來得及嗎?
也不能這樣保證。
雙緩衝讓搬運和處理有機會重疊,但沒有讓 CPU 的計算時間憑空消失。
如果一塊資料搬好只要 1 毫秒,CPU 卻要花 3 毫秒才能處理完,兩塊空間也不能無限接住一直進來的資料。
來源如果是記憶體,可以先等 CPU 處理完,再啟動下一次複製。但如果是持續取樣的周邊,外面的資料可能不會等我們。接收端停住後,FIFO 仍可能滿,後續資料也可能遺失。
傳送方向則要反過來看:CPU 在準備下一塊時,DMA 可以讀取已經準備好的那一塊。若 CPU 準備不及,周邊仍可能斷糧,輸出時序也會受影響。
因此,還要一起看每塊大小、資料產生速度、CPU 處理時間,以及對方能不能暫停。增加緩衝區可以吸收短暫落差,不能長期補上處理速度不足。
如果需要縮短區塊切換的空檔,還能使用 DMA 完成中斷、通道串接等方式,提前安排下一段傳輸。RP2040:DMA 的中斷重設與通道串接範例
但串接也只是在安排何時啟動下一個通道,不會替 CPU 確認那塊資料是否已處理完。先把 A、B 的使用順序弄清楚,再把自動化加進去,比較知道自己省掉了哪一步。
十一、先知道搬哪裡,再知道什麼時候能用
最開始只是想讓 CPU 少搬幾筆資料,結果一路看下來,還是多了不少設定。
但把它拆開,其實都在回答幾個具體問題:從哪裡讀、寫到哪裡、一筆多寬、搬多少筆,以及下一次要不要換位址。
這些條件確定後,再設定通道、啟動,等到完成才取用結果。接到 PIO 時,DREQ 讓搬運配合 FIFO 的需求;想讓 CPU 同時處理資料,就再用兩塊緩衝區安排交接。
所以我覺得,這次比起背下整串函式,更重要的是知道:現在誰在使用這塊資料、搬運到底完成到哪一端,以及下一個人什麼時候才能接手。
count 是四筆,還是四個位元組?DMA 已經結束,是資料進了 FIFO,還是腳位真的送完?下一輪又要用 A 了,CPU 是否已經讀完?
這些問題對上之後,那些參數才比較不會只剩下一排需要猜的 true 和 false。
至於完成中斷怎麼寫、通道怎麼串接,以及更長時間的連續收送,就留到後面。先把這四筆資料搬對,再讓兩邊忙起來。畢竟搬得很快,結果搬錯地方,應該也很難算是進步。
參考資料
- Raspberry Pi:RP2040 Datasheet:第 2.5 章 DMA,包含通道、傳輸寬度、位址對齊、DREQ,以及中斷重設和串接範例。
- Pico SDK:Hardware APIs/hardware_dma:通道取得與歸還、設定、啟動、狀態查詢和完成等待。
- Pico SDK:hardware/dma.h(2.1.1):基本傳輸寬度、位址遞增,以及
dma_channel_configure的參數順序與筆數語意。 - Pico SDK:hardware/dma.h(目前原始碼):完成等待與編譯器屏障;較新的介面也提供傳輸筆數編碼輔助函式,本文只使用可直接表示的小筆數一般傳輸。
- Pico SDK:hardware_dma/dma.c:claim、unclaim 與通道清理的實作差異。
- Pico SDK:RP2350 platform_defs.h:RP2350 的 DMA 通道數量。
- Pico SDK:hardware/pio.h:PIO TX/RX 的 DREQ 選擇與 FIFO 存取介面。
- Raspberry Pi:pico-examples/hello_dma:官方記憶體複製入門範例。
- Raspberry Pi:pico-examples/ws2812_parallel.c:DMA 配合 PIO DREQ 與通道串接的應用範例。
客官怎麼看
看完有話想說,留在這裡。罵我也可以,罵別人更好。
可用 GitHub 登入,或以筆名題字;Email 選填。地區章依網路位置辨識,臺灣可顯示縣市;編號用來區分留言。