信賴區間
| 內容分類 | 學習筆記 |
|---|---|
| 筆記系列 | 統計學 |
| 筆記篇幅 | 長篇筆記 |
| 學習狀態 | 持續整理 |
| 本篇主題 | 估計與不確定性 |
一個平均數還不夠,我們還想知道它有多不確定。從餐費與身高,理解信賴區間、標準誤,以及那個容易誤會的 95%。
所以,之前已經介紹過 p-value 了,那今天就來補上另一個在研究裡很常看到的東西,也就是 信賴區間(Confidence Interval,CI)。
先簡單複習一下。p-value 問的是:如果虛無假設是對的,其他檢定假設也都成立,那出現目前這麼極端,甚至更極端的結果,機率有多大?
但我們在那篇後面也有提到,研究不會只看 p-value。就算結果達到統計顯著,我們還是會想問:所以,到底估計出多少?這個數字又有多準?
這就是信賴區間能幫忙的地方。
如果先用一句話介紹,可以把它想成:
除了告訴你估計是多少,也給一段範圍,讓你知道這個估計還有多少不確定性。
嗯,感覺還是有一點抽象。沒關係,我們一樣從例子開始。
一、只給一個平均數,夠嗎?
假設你今天突然很好奇:
「全校學生平均一個月花多少餐費?」
但全校有 10,000 個學生。總不可能為了滿足你的好奇心,真的一個一個抓來問吧?
所以,你隨機找了 100 個學生,問他們每個月花多少餐費,最後算出平均是 6,000 元。
好,問題來了。你真的敢直接說,全校學生的平均餐費就是 6,000 元嗎?
應該不敢吧!畢竟只問了 100 個人,誰知道是不是剛好抽到一群特別愛吃,或是特別省錢的人?換一批人,可能就變成 5,800 元,也可能變成 6,200 元。
這裡就要先分清楚兩個東西:
- :樣本平均數,也就是這次抽到的 100 個人,平均花多少錢。
- :母體平均數,也就是全校學生真正的平均餐費。
我們這次算出來的是:
但真正的 呢?
不知道。不然我們也不用在這裡學統計了。
所以,樣本平均數不一定等於母體平均數。 我們要估計的,是全校這群學生在這段時間的平均餐費。這個數字不會因為你換一批人來問就改變,會變的是你算出來的樣本平均數。
那既然有這種不確定性,我們能不能不要只報一個數字,而是給一段估計範圍?
可以。假設我們用統計方法,算出一個 95% 信賴區間:
也就是用 5,500~6,500 元這段範圍,來估計全校真正的平均餐費。這裡的數字先拿來舉例,兩端怎麼算,後面再說。
但我相信,大家現在一定有一個疑問:
「所以,真正的平均餐費有 95% 的機率,落在這段範圍裡?」
欸,還真的不能這樣解釋。
這也是信賴區間最容易讓人卡住的地方。
二、95% 到底在說什麼?
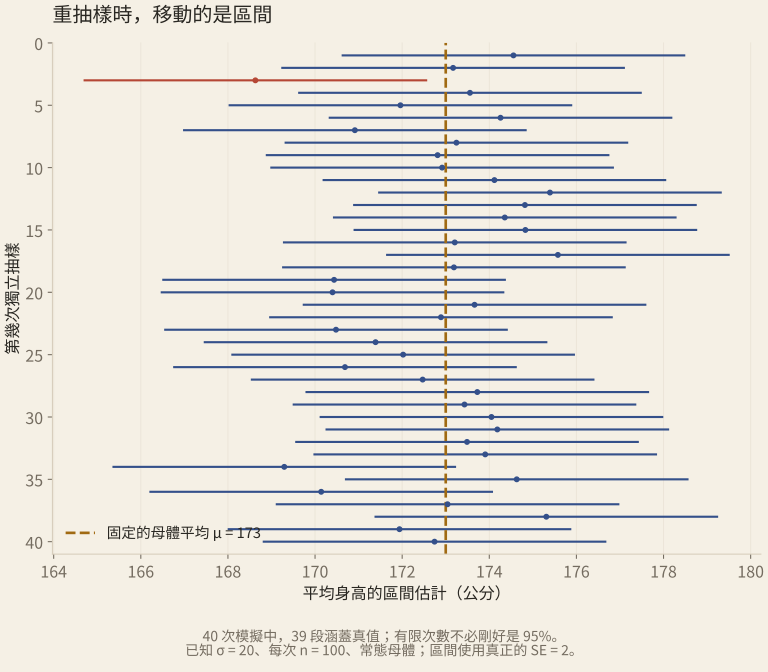
想像你有一台機器。每按一次,它就會重新從全校隨機抽出 100 名學生,再用同一套方法,算出一個 95% 信賴區間。
假設你今天很閒,連續按了 100 次,就會得到 100 個區間。
現在再假設,我們有辦法知道全校真正的平均餐費,其實是:
注意,這個 6,200 元不會因為機器抽到不同的人就改變。會改變的是樣本,以及用樣本算出來的區間。
有些區間可能是 5,500~6,500 元,有些可能是 5,900~6,700 元,也可能有一段是 5,100~6,100 元。
前兩段有包含真正的 6,200 元,最後一段就沒有。
那 95% 到底在哪裡?假設這台機器用的方法沒問題,需要的假設也都成立。一直這樣抽下去,算出很多很多個區間,大約 95% 會包含真正的平均數,另外約 5% 會漏掉它。
這就是 95% 信賴水準(Confidence Level) 的意思。不過,按 100 次可不保證剛好有 95 段包含它。這個 95%,要看一直重複抽樣,長期下來的比例。
那為什麼不能說「這一次的區間有 95% 的機率包含真正平均數」?
因為全校真正的平均餐費就擺在那裡,不會跟著我們抽樣而改變。而抽完之後,這次的區間也定下來了,例如前面的 5,500~6,500 元。
這段範圍要嘛有包含真正的平均數,要嘛沒有,只是我們不知道。這就是這裡採用的頻率學派的看法。
所以,95% 講的是還沒抽樣時,用這套方法算出的區間有多大機會包含真正的平均數。抽完以後,就不能直接把它當成手上這段區間的機率了。
聽起來很繞,對吧?其實可以先抓住這個差別:
一直重抽、一直算,大約 95% 的區間會包含真正的平均數。但手上這一段有沒有包含它,我們還是不知道。
這也有點像之前 p-value 那篇提到的事情:看到百分比,總會很想直接拿來回答自己最在意的問題。但還是得先看清楚,這個數字原本在回答什麼。
還有,這裡估計的是全校的平均餐費,不是說全校 95% 的學生,餐費都落在 5,500~6,500 元。
平均數在哪裡,跟每個人的餐費分散在哪裡,是兩個問題。
三、區間到底應該多寬?
好,知道 95% 的意思了。但前面那段 5,500~6,500 元,到底是怎麼決定的?
我們換一個例子。假設你想估計某個母體的平均身高,抽樣後得到平均 173 公分。
那我直接給一段 100~250 公分的範圍,可以嗎?
感覺很難沒包含真正的平均身高,但這樣到底提供了多少資訊?繞了一圈,大家還是不知道平均身高大概是多少。
所以,光是範圍夠大也沒用,我們還是希望能估得準一點。那這段範圍到底能縮到多窄?主要就看下面幾件事。
1. 資料本身有多分散?
想像有兩所學校。
A 學校的學生身高很接近,大部分集中在 168~172 公分附近。B 學校的身高就比較分散,有些人只有 150 公分,有些人則有 190 公分。
現在分別從兩校隨機抽 100 個人,剛好算出的平均身高都是 170 公分。
雖然這次的平均數一樣,但如果重新抽一批人,哪一所學校算出的平均數,通常比較不容易大幅變動?
通常會是 A 學校。因為大家身高接近,換一批人,平均也不太容易差很多。B 學校則可能因為這次多抽到幾個高個子,或多抽到幾個矮個子,讓平均數變動得比較明顯。
所以,如果抽的人數一樣,信賴水準等條件也一樣,資料越分散,估計平均數的信賴區間通常就越寬。
2. 你抽了多少人?
那如果不是抽 100 個人,而是抽 1,000 個人呢?
如果抽樣方式沒問題,其他條件也差不多,問的人越多,通常就比較不容易因為剛好多問到幾個高個子,讓平均數差很多。估計比較穩,信賴區間也就會比較窄。
但這裡要注意,抽得多,不代表抽得有代表性。
你如果只在籃球隊門口找人,再怎麼努力收集身高,也不一定能代表全校學生。多問一些人,可以讓隨機抽樣的結果比較穩,但如果一開始就找錯人,問再多也不會自動變準。
這部分先記住就好,不然我們又要一路岔到研究設計了。
3. 你選了多高的信賴水準?
前面一直用 95%,但信賴水準也可以選 90% 或 99%。
看到這裡,你可能會想:「那當然選 99% 啊,誰會想要比較低的?」
嗯,如果沒有代價,大家確實都可以這樣選。
但拿同一份資料,用同一類方法來算,信賴水準越高,區間通常就越寬。
例如,先用示意數字看這個關係:
| 信賴水準 | 平均身高的信賴區間 |
|---|---|
| 90% | 170~176 公分 |
| 95% | 169~177 公分 |
| 99% | 167~179 公分 |
如果把每次算出的區間想成一張網,想讓它在重複抽樣時更常網到真正的平均數,就得把網放大一點。
但網放大,估計範圍也就變寬了。
所以,同樣一份資料,想把信賴水準拉高,通常就得接受範圍變寬。 沒辦法兩邊都要。
四、所以信賴區間怎麼算?
前面講了很多直覺,現在終於要進到公式了。
先別急著跑。我們這裡估計平均數,常見的區間可以寫成:
白話就是:先算出一個估計值,再看資料和信賴水準,決定左右各留多少空間。
如果適合用常態分配來近似,平均數的 95% 信賴區間,常見的寫法就是:
我相信看到這裡,大家又會有兩個問題:SE 是什麼?1.96 又是哪來的?
我們一個一個看。
1. SE:換一批樣本,平均數會波動多少?
SE(Standard Error,標準誤),放在這篇裡,就是在看:每次換一批人,算出來的平均數通常會差多少?
例如,每次都隨機抽 100 個人,算出的平均身高可能是:
| 第幾次抽樣 | 樣本平均身高 |
|---|---|
| 第一次 | 173.0 公分 |
| 第二次 | 172.5 公分 |
| 第三次 | 174.1 公分 |
| 第四次 | 172.8 公分 |
| 第五次 | 173.6 公分 |
這些數字只是拿來舉例。重點是,每次抽到的人不一樣,平均數也會跟著變。標準誤越大,就表示換一批人,平均數通常也會變動得越明顯。
這裡很容易把兩件事混在一起:
- 標準差:這群人的身高,彼此有多分散。
- 平均數的標準誤:換一批人抽樣,算出的平均身高有多不穩定。
一個在問「每個人差多少」,另一個在問「每次抽完,平均數會差多少」。
那難道為了知道 SE,我們真的得一直重新抽樣嗎?
不用真的抽那麼多次,我們可以用手上這份資料來估計。不過有幾個前提:每個人的資料要互相獨立、來自同一個分布,而且這個分布的變異數要有限。符合這些條件時,樣本平均數的標準誤可以這樣估:
這裡的 是樣本標準差, 是樣本數。 上面那頂帽子,就是提醒你:這也是用資料估出來的。等一下就拿它來算。
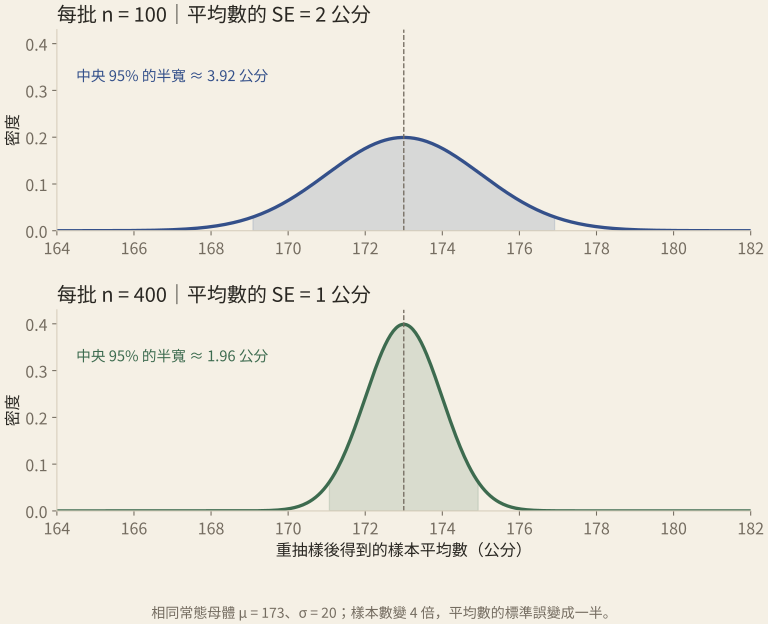
再回頭看這個式子,是不是就接起來了?資料越分散, 越大,估出來的標準誤也越大。反過來,如果 一樣,分母的樣本數越多,估出來的標準誤就越小。
但注意,分母是 。其他條件一樣的話,想讓標準誤降到一半,樣本數可不是加倍就好,而是得增加到四倍。
嗯,精確度也是要花成本的。
2. 1.96:為什麼要留這麼多空間?
那剩下的 1.96 呢?
這個數字是從 常態分配(Normal Distribution) 來的。
先不用急著把整個常態分配學完。我們先想像一直重複抽樣,每次都算出一個平均數。如果這些平均數形成常態分配,而且我們知道真正的標準誤,那就有下面這個關係:
抽到的樣本平均數,有 95% 的機率,會落在真正平均數左右約 1.96 個標準誤的範圍內。
也就是:
這裡說「約」,是因為 1.96 本身是四捨五入後的數字。
那接下來呢?其實只是換個方向看。
如果樣本平均數離真正平均數,沒有超過 1.96 個標準誤,那反過來,以樣本平均數為中心,左右各留 1.96 個標準誤,也就能包含真正的平均數。
所以可以改寫成:
原本在看「樣本平均數會落在哪裡」,換個方向,就變成「怎麼用樣本平均數畫出一段區間」。
但實際計算時,標準誤通常也是估出來的,那些樣本平均數也不一定剛好形成常態分配。所以前面才一直說,這是近似公式,要先看適不適合用。
那實際計算時,都用 1.96 就好了嗎?
不一定。像我們想估計母體平均數,卻不知道母體標準差時,就常會改用 t 信賴區間:
這裡的 ,是從自由度為 的 t 分配查出來的臨界值。先把它想成:在這個公式裡,接替 1.96 的那個數字。樣本數大時,它會接近 1.96;樣本數小時,差別就比較明顯。
如果每筆資料互相獨立,而且都來自同一個常態母體,這個 t 區間就能做到前面說的 95% 涵蓋率。母體不是常態時,就得再看樣本數夠不夠、資料分布長什麼樣、有沒有離群值,才能判斷這樣近似合不合適。
這篇先用 1.96 把常態近似的想法講清楚。至於估計別的東西、換一種抽樣方式,或用其他統計方法時,信賴區間也可能長得不一樣,不一定都是左右「加減一段距離」。
3. 把數字放進去
好,終於把需要的東西湊齊了。我們用一組示意資料來算:
- 隨機抽取 個人。
- 樣本平均身高 公分。
- 樣本標準差 公分。
先估計標準誤:
假設這份資料和抽樣方式,適合用前面說的常態近似,那就把數字放進去:
得到近似的 95% 信賴區間:
所以,根據這次抽樣,我們用 169.08~176.92 公分這段範圍,估計母體的平均身高。
那這裡的 95% 呢?一樣回到前面那台機器。只要需要的假設成立,常態近似也適合,一直重複抽樣、算區間,長期下來,約有 95% 的區間能包含真正的平均數。
到這裡,就把「估計值」「標準誤」和「信賴水準」接起來了。
五、回到一開始,我們多知道了什麼?
如果只告訴你平均身高是 173 公分,你知道的是一個估計值。
但如果再告訴你,95% 信賴區間是 169.08~176.92 公分,你就不只看到 173 這個數字,還能看出:用這套方法估計,範圍大概有多寬,我們還有多少不確定性。
這也是為什麼研究不會只看 p-value。除了問「如果虛無假設是對的,這個結果有多奇怪」,我們也想知道:到底估計出多大的效果?這個估計又有多準?
當然,區間很窄,也不代表研究就一定可靠。前面籃球隊的例子已經提醒過我們:抽樣或模型出了問題,光把區間算得很漂亮,也救不了它。
最後再挖個坑吧。我原本想把抽樣分配、常態分配,以及信賴區間的數學推導一起寫進來,但看了一下篇幅,感覺再繼續,大家就要被我送去修統計學了。
所以這篇先把直覺和基本算法接起來。至於為什麼抽樣平均數會接近常態、t 分配又是怎麼冒出來的,等先備概念補齊,再來整理比較完整的數學版本。
畢竟如果連常態分配都還沒介紹,就要大家直接接受這一整套,確實有一點強人所難。
參考資料
- NIST:Confidence Limits for the Mean:平均數信賴區間的解讀、寬度與 t 區間公式。
- NIST:Normal Distribution:常態分配,以及樣本平均數的抽樣分布。
客官怎麼看
看完有話想說,留在這裡。罵我也可以,罵別人更好。
可用 GitHub 登入,或以筆名題字;Email 選填。地區章依網路位置辨識,臺灣可顯示縣市;編號用來區分留言。