蒙地卡羅
| 內容分類 | 學習筆記 |
|---|---|
| 筆記系列 | 圖學 |
| 筆記篇幅 | 長篇筆記 |
| 學習狀態 | 持續整理 |
| 本篇主題 | 隨機與積分 |
前幾篇一直東採樣、西採樣,這次終於來補上背後的蒙地卡羅。從丟骰子開始,把隨機採樣、取平均和渲染方程式接起來。
對,沒錯,我們要來碰這個大魔王主題了。
前幾篇一直提到「採樣」,東採樣、西採樣,也介紹了 PDF、NEE 跟 MIS。那今天終於要來補上:為什麼抽一些樣本,再把貢獻平均,就能拿來估計光照?
這背後很重要的一套方法,就是 蒙地卡羅方法(Monte Carlo Method)。
先說,蒙地卡羅的應用非常廣,不只出現在渲染裡。但這篇依然會集中在 PBR,尤其是 Path Tracing 裡的使用。不然每個領域都展開,這篇大概就寫不完了。
一、為什麼叫蒙地卡羅?
回到主題,不免俗的,第一個問題還是:什麼是蒙地卡羅?
不過,在進入那些數學之前,我們先換一個切入點好了。為什麼「叫」蒙地卡羅? 這件事其實蠻有趣的。
相信各位有在賭博的,可能聽過摩納哥那個以賭場聞名的地區,Monte Carlo。
1940 年代,Stanislaw Ulam(烏拉姆)和 John von Neumann(馮紐曼)等人,推動了用隨機採樣進行電腦計算的方法,當時的重要應用之一,是模擬中子的傳播。
如果先不管那些物理細節,可以把想法理解成:與其直接算出所有可能情況,不如依照模型裡的機率,模擬很多次,再用結果估計我們想知道的量。
那跟賭場有什麼關係?
根據 Nicholas Metropolis 本人的回憶,這個名字是他提出的,還跟 Ulam 一位會向親戚借錢、說自己非去 Monte Carlo 不可的叔叔有關。
嗯,連數學方法的命名,都能牽扯到親戚借錢去賭場。
這種依靠隨機性的計算方法,配上一個賭場的名字,確實也蠻好記的。詳細故事可以看 Metropolis 的回憶文章。
好了,小趣聞介紹完,相信大家至少記住名字了。當然,我本人還是非常相信大家沒有去賭博的,對吧……
我們繼續。
二、先不要管光,我們來丟骰子
如果先用一句白話介紹,蒙地卡羅可以理解成:
依照設定好的機率模型,隨機試很多次,再用這些結果估計我們想知道的答案。
它特別適合用來處理那些很難直接算完的問題。不過,為了先看懂它怎麼運作,我們故意從一個很容易算的問題開始。
場景不用換,就接著剛才的賭場。假設我們想知道:
「一顆公平的六面骰子,平均會丟出幾點?」
每個點數出現的機率都是 ,所以直接算:
答案是 3.5 點。
這裡的「平均」,指的是一直丟下去,長期平均的結果,也就是期望值。不是說骰子真的有一面叫 3.5 點。
但假設我們先不要用上面的方式直接求答案,只靠反覆丟骰子呢?
那就丟很多次,把每一次的點數記下來,再算平均。這裡假設每次投擲互相獨立,而且骰子真的公平。
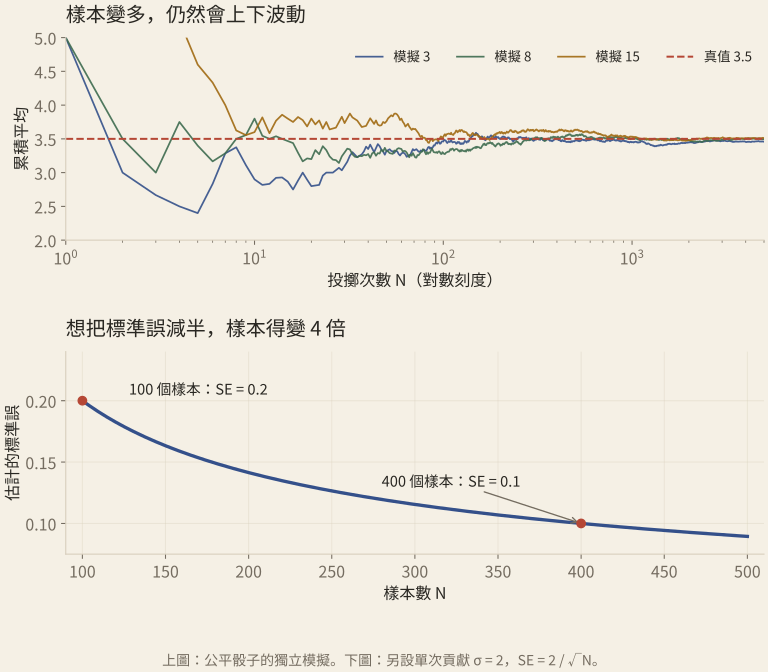
你可以先丟 1 次,再丟 10 次,最後丟 100 次。丟得少,算出來的平均可能差很多;丟得多,平均通常會比較穩定,慢慢接近 3.5。
但注意,不是每多丟一次,結果就一定更接近 3.5。 下一次可能剛好丟出 6,反而把目前的平均拉遠一點。它講的是大量採樣之後的行為,不是每一步都保證進步。
好,我相信大家看到這裡,應該還是有點不滿足。
「你一直說丟很多次,就能逼近答案。但我丟了 100 次,也只是拿到 100 筆資料啊,然後呢?」
確實,所以我們直接算一次。
假設這次丟了 100 次,得到下面這組示意結果:
| 點數 | 出現次數 |
|---|---|
| 1 | 14 次 |
| 2 | 18 次 |
| 3 | 15 次 |
| 4 | 19 次 |
| 5 | 16 次 |
| 6 | 18 次 |
| 總計 | 100 次 |
第一步,把每次的點數加起來。因為已經整理成出現次數,所以可以寫成:
第二步,除以投擲次數:
這個 3.59,就是這次透過隨機實驗得到的估計值。
真正的答案是 3.5,所以這次的絕對誤差是:
嗯……
「欸,這不就平均嗎?幹嘛套上一個蒙地卡羅,搞得好像很厲害?」
對,剛剛的計算,真的就是取平均。
三、所以,蒙地卡羅跟算平均差在哪?
這裡要看的是:我們拿這個平均,來回答什麼問題?
假設老師給你五個成績:
你要算這五個人的平均成績:
算完,你就知道這五個人的平均是 84 分。你要描述的就是眼前這五個人,資料已經全部在手上了。
但剛剛丟骰子,我們在意的不是只有「這 100 次平均幾點」,而是想用這 100 次,估計這顆骰子的長期期望值。
所以算式雖然也是平均,它現在被拿來當作一個估計工具。
這也跟之前信賴區間那篇有點像:我們問了一部分學生,會想用樣本平均數估計全校的平均數。
不過,學生的例子通常叫做抽樣調查;這篇談的蒙地卡羅,重點會放在讓電腦依照機率模型產生樣本,再用樣本估計數值答案。兩者都用到隨機採樣與統計估計的想法,但不是看到一個樣本平均,就全部叫蒙地卡羅。
還有,蒙地卡羅也不是只有「把抽到的原始數字平均」這一種寫法。剛才的骰子很單純,等一下換成積分,就會需要用到 PDF 與採樣補償。
對,之前 PDF 那篇講過的東西,又要回來了。
四、那 PBR 到底為什麼需要它?
好,丟完骰子,也該把光請回來了。
前面選了一個連手算都很快的問題,大家當然會覺得,多丟那 100 次骰子根本是在浪費時間。
但如果今天沒辦法輕鬆把答案寫出來呢?這就是我們在 Path Tracing 裡遇到的情況。
先給一個直覺說法:
場景裡可能把光帶到攝影機的路徑太多了。Path Tracing 透過隨機採樣其中一部分,再配上正確的權重,估計這些光路的總貢獻。
這裡說的是 Path Tracing 常用的求解方式。PBR 是描述光與材質的物理模型,並不是所有使用 PBR 的渲染,都一定得靠蒙地卡羅。
那為什麼 Path Tracing 常用這一套?我們還是得請出老朋友,渲染方程式:
依然熟悉,但這次真的不重新介紹每個符號了。還不熟的話,先回去看〈關於渲染那檔事〉。這裡一樣先只考慮表面反射,並假設沒有霧或煙這類參與介質。
我們先看後面這段積分:
它想把表面這一側,所有入射方向帶來的反射貢獻加起來。
如果情況很單純,例如入射光在半球上均勻、材質也是簡單的 Lambertian Diffuse,那這個積分可以直接算。
但實際場景就沒那麼客氣了。
- 不同方向可能看到不同光源,光的強度不一樣。
- 有些方向被物體擋住,光根本照不過來。
- 材質可能只在一小片方向有很強的反射。
- 入射光可能還經過其他表面,反彈了好幾次才到這裡。
最後一點,還會接回之前提過的遞迴依賴:
我們想知道這面牆收到多少光,但其中一部分來自另一面牆;而另一面牆反射多少光,又還等著我們算。
所以,不只是眼前這一個半球難積分,連裡面的 ,都可能是另一個還沒解完的光照問題。
把一次、兩次、三次反彈繼續展開,就會變成對整條光路上多個位置、方向的積分。這也是為什麼,前面說的是「抽光路」,而不只是抽一個方向。
當然,數值積分不只有蒙地卡羅。但如果每次反彈都把可能的方向切成很多格,一格一格往下算,需要處理的組合很快就會多到受不了。
怎麼個多法?先故意把問題縮小,假設每個交點只挑 10 個方向,而且每個方向都繼續往下算。考慮一次散射,有 10 種方向選擇;再多一個交點,組合就變成 種;第三次就是 1,000 種。
這還只是假設每次挑 10 個方向而已。每多一次散射,就多一組要決定的位置與方向,這就是這裡說的「維度增加」。
蒙地卡羅的好處是,我們可以選擇要花多少樣本,去估計這類高維度積分。例如先抽一條路徑,每次只沿抽中的方向繼續,算出這條路徑的貢獻;再換一條,重做一次。不必先把所有方向組合列出來。
聽起來很合理,但最重要的問題還沒回答:
隨機抽一些,為什麼就能估計積分?
五、先算一次,抽幾個位置怎麼估面積?
先把光放旁邊一下。我們換一個可以直接算出答案的例子,看看抽樣到底怎麼拿來估計積分。不然直接從骰子跳到一大串符號,確實有一點太突然了。
假設我們想算:
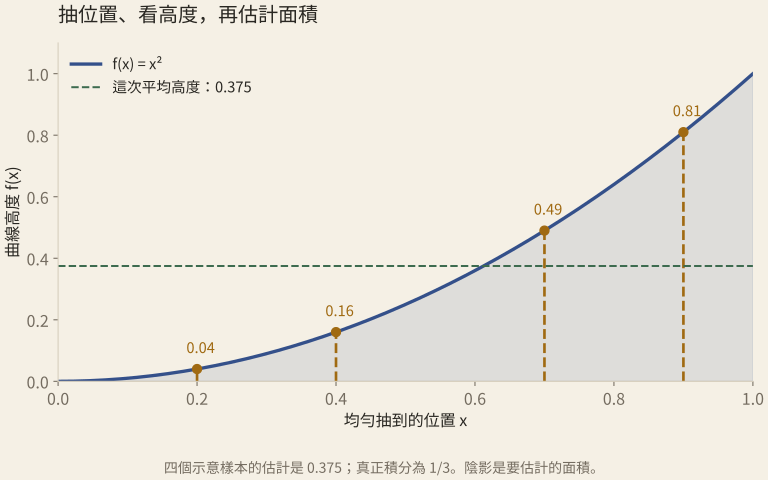
先把右邊的答案遮起來。我們想知道的,是 這條曲線,在 0 到 1 之間下方的面積。
如果你還記得函數圖形,可以想成:橫著走到某個位置 ,曲線在那裡的高度就是 。例如走到 0.2,高度是 0.04;走到 0.9,高度就是 0.81。
那算面積,跟看這幾個高度有什麼關係?
先想一個長方形,面積就是「寬度乘上高度」。曲線下方雖然不是長方形,但如果我們知道整段範圍的平均高度,一樣可以用「寬度乘上平均高度」,得到面積。
現在的問題,就是不知道整段的平均高度。所以我們隨機挑幾個位置,看看那裡有多高,再用這些高度的平均來估計。
這次在 0 到 1 之間均勻採樣,所以這個範圍內的 PDF 是:
假設抽到四個位置,這裡用一組示意數字:
我們先把每個位置的高度列出來:
| 第幾個樣本 | 抽到的位置 | 那裡的高度 | 除以 PDF 之後 |
|---|---|---|---|
| 1 | 0.2 | 0.04 | |
| 2 | 0.4 | 0.16 | |
| 3 | 0.7 | 0.49 | |
| 4 | 0.9 | 0.81 |
注意,我們要平均的是第三欄那些高度,不是第二欄抽到的位置。這裡除以 PDF 都是除以 1,數字暫時沒有變;等一下換一種抽法,就會看到它的作用。
現在把四次的結果平均:
這次抽到的高度,平均是 0.375。而這段範圍的寬度剛好是 1,所以估計的面積就是 。
再把真正的答案拿回來,積分約是 0.3333,這次估出來是 0.375。
不完全一樣,很正常,我們只看了四個位置。跟骰子一樣,這四個樣本的平均,不保證剛好等於整體的平均。
但這裡應該已經比較看得出來,我們到底做了什麼:抽位置、算高度,再用抽到的高度,估計整段範圍的平均高度,最後換成面積。
那我相信大家會接著問:
「所以只要一直抽、一直平均,就好了?那前幾篇說的 PDF 補償,到底什麼時候才有用?」
好,剛才只是最單純的情況。接下來我們保留這個例子,把背後的數學接上去。
六、從這四個數字,接到一般的估計式
1. 我們原本想算的是一個積分
剛才算的是 在 0 到 1 之間的面積。如果把函數與範圍換成別的,目標就寫成:
你可以把它想成,計算 在 到 之間,曲線下的總面積;如果有一部分在橫軸下方,那一部分就帶負號。
這裡的 是我們想知道的答案, 則是每個位置要計算的東西。對照剛才,就是 、、,而 是那個約等於 0.3333 的面積。
如果函數很簡單,直接積分就好。但如果很難找到解析解,我們能不能像剛才丟骰子一樣,只抽一些位置來算?
可以。但要先說清楚,怎麼抽。
2. 用 PDF 決定抽哪裡
對,就是我們熟悉的 PDF,機率密度函數。
選一個定義在 上的 ,滿足:
白話說,密度不能是負的,全部範圍的機率加起來要是 100%。
它決定哪些位置附近比較容易被抽到。你可以平均抽,也可以刻意多抽某些地方。
例如剛才用 ,是讓相同寬度的區間有一樣的抽樣機會。那如果換成之前 PDF 那篇用過的 呢?
抽樣範圍還是 0 到 1,但右邊更容易被抽到。偏偏 也是越往右越高。如果直接平均抽到的高度,就會讓右邊那些較高的值占比較多,估出來的東西也就變了。
所以我們要補償這個差別:比較常抽到的地方,每次少算一些;比較少抽到的地方,抽到時多算一些。
所以每次抽到 ,真正要拿來平均的是:
這次把兩種抽法放在同一個表裡,看抽到相同位置時,各自要記下多少:
| 抽到的位置 | 原本高度 | 均勻抽, | 偏向右邊抽, |
|---|---|---|---|
| 0.04 | |||
| 0.64 |
換成偏右邊的抽法以後,右邊附近會更常出現,但每次算進平均的數字變小;左邊附近比較少出現,抽到時就多算一些。
注意,這張表只比較「抽到這個位置時,怎麼算」。兩種抽法實際產生的樣本,當然不會總是同一組。
「好,又是除以 PDF。我知道你前面講過,但為什麼這樣除,就能拿來算積分?」
這次我們就把中間那一步補上。
3. 把積分改寫成期望值
先假設有貢獻的地方, 都大於 0,不然分母就不能這樣除。更精確的條件,等一下放在補充裡。
先只看一個位置,例如剛才的 。用 時,補償後的數字是 ;再乘回密度,就是 ,回到原本的高度。
也就是說,我們在每個位置都能把 拆成「補償後的數字」乘上「那裡的密度」。整段積分也就能寫成:
看起來只是多此一舉,畢竟 又消掉了。剛才的 0.64 也沒有因此變成別的數字。
但我們接下來要把它讀成:按照 抽樣時,補償後的數字,長期平均會是多少?
這就要用到期望值。先不用急著回去修機率論,它可以先理解成:把所有可能結果,依照它們出現的機率,算出理論上的加權平均。
像公平骰子的期望值就是:
骰子只有六種結果,所以可以一項一項加。現在位置是連續的,不能把所有位置都列成六行,就改用積分來加總。
這裡先多借一個字母 ,表示「抽到位置後,最後記進平均的數字」。例如剛才用 ,抽到 0.8,我們最後記的是 0.4,這就是 。
若 按照密度 產生,某個結果 的期望值就寫成:
其中 就是期望值的符號, 是還沒抽出來的隨機位置。像「下一次會抽到哪裡」,我們還不知道;真的抽到 0.8 之後,才把它代進去,算出要記下的 0.4。
而右邊的 ,可以先想成:位置 附近,一小段範圍所占的機率。把每一小段的結果依機率加權,再全部加起來,就是連續情況的期望值。它對應的角色,就像骰子算式裡每項乘上的 。
現在對照一下。如果我們讓:
是不是就剛好得到:
後面的 ,就是說這個位置真的按照 來抽。
這條等式沒有說「抽一次就得到積分」。它說的是:每次記下 ,這個數字的理論長期平均,剛好等於我們想算的面積 。
繞了一圈,我們終於把兩件事接起來了:
我們想算的積分,等於「按這個 PDF 抽樣後,每次貢獻除以 PDF」的期望值。
所以除以 PDF,並不是為了讓公式看起來比較專業。它正是讓抽樣機率與計算權重抵消,接回原本積分的那一步。
4. 再用樣本平均,估計這個期望值
那要怎麼估計期望值?
回到骰子就好了。剛才我們想估計長期平均時,不就是丟很多次,再取平均嗎?
這次也一樣。按照 ,獨立抽出 個位置。「獨立」先理解成,每次都重新抽,不拿上一次的結果決定這次往哪裡抽:
拿前面的四個樣本來對照, 就是 4, 就是第一個位置 0.2, 就是第二個位置 0.4,後面照著排下去。
每個位置都算一次 ,最後平均:
這就是這裡使用的蒙地卡羅積分估計式。
先別被那串符號嚇跑。 是樣本數, 是全部加起來, 上面的帽子,則是在提醒你:這是用 個樣本得到的估計,還不是已知的真正答案。
例如用 時,第一項就是 ,第二項是 。把四項全部加起來,再除以 4,就是前面算出的 0.375。
所以這條公式,只是把剛才那張表的操作,寫成不管抽幾次都能用的版本。
把整個流程換回白話:
按 PDF 抽位置,算出每次經過 PDF 補償的貢獻,再把這些貢獻平均。
這裡的「不偏」和「越抽越接近」,需要什麼前提?
先說最重要的:有面積要算的地方,不能整段都抽不到。 例如我們要算 0 到 1 的 ,如果抽樣永遠只落在 0 到 0.5,那右半邊的面積就被漏掉了。左邊再怎麼補償,也拿不回從來沒抽過的右邊。
數學上,前提是 絕對可積分,而且在 的地方, 幾乎處處為正。
「絕對可積分」,是說先把 的負值翻成正值,再把面積加起來,總量仍然有限。剛才的 在 0 到 1 上,面積就是有限的 ,沒有這個問題。
而「幾乎處處」允許忽略不影響積分的零測度集合。例如一個精確的位置沒有寬度,漏掉它不會少掉一塊面積;但漏掉 0.5 到 1 這一整段,就完全不同了。
若樣本真的按照 產生,分母也使用同一個 PDF,就有:
這叫做不偏。先想像固定每次只抽四個樣本,整套實驗重做很多回。第一回估出 0.375,另一回可能偏低,還有一回可能偏高;這些「每回估計值」的理論平均,等於真正答案 。
它不代表手上這一次一定算準,也不必先等到樣本數無限多,才談得上不偏。
接著才是另一個問題:如果不固定抽四次,而是同一回裡,一直增加樣本呢?
如果樣本還是獨立、同分布的,就可以用大數法則說明:樣本數一直增加時,估計會幾乎必然收斂到 。「同分布」就是這些樣本使用同一個 ,不會前半段照一條 PDF 抽,後半段換了規則,卻還當成同一套來算。
「幾乎必然」的意思,是這件事發生的機率為 1;不保證每一串你能想像的抽樣結果都會收斂,但不收斂的那些情況,機率合起來是 0。
這和「每增加一個樣本,誤差就一定變小」是兩回事。即使整體正在收斂,中間仍然可以忽近忽遠。
5. 最後補上,範圍不只寬 1 的情況
回頭看剛才算面積時,我們說過「寬度乘上平均高度」。但一路算下來,寬度好像不見了?
它其實藏在 PDF 裡。這裡有個很容易順手帶過的小陷阱:不是所有均勻採樣的 PDF 都等於 1。
剛才是因為範圍剛好從 0 到 1,寬度是 1。如果是在一般的 上均勻抽,密度應該是:
例如範圍是 0 到 2,寬度變成 2,均勻密度就得是 。因為密度乘上整段寬度,必須是 ,才能保證總機率是 100%。
那每次除以 ,不就等於乘上 2 嗎?剛才說的範圍寬度,就在這一步乘回來了。
代回估計式,就會變成:
所以,均勻抽位置後,函數值的平均,還要乘上區間寬度,才是積分的估計。 前面的寬度剛好是 1,才讓這件事看起來像單純取平均。
而一般的 寫法,已經把這個範圍大小,以及抽得不平均時的補償,都放進去了。
七、把蒙地卡羅放回渲染方程式
好了,骰子也丟了,面積也算了,我們終於可以回到光。
1. 這次抽到的,不是 0.2,而是一個方向
先想像攝影機的光線,打到一塊地板上的位置 。現在要算的是:這塊地板往攝影機的方向,反射出多少光?
地板可能收到頭頂燈泡的光,也可能收到牆壁反射的光。要回答這個問題,就得把不同入射方向的貢獻加起來。
前面我們從 0 到 1 之間抽一個位置,抽到 0.2,就去看 在那裡有多高。現在則從地板上方的半球抽一個方向,抽到朝向燈泡的方向,就去看那裡照過來多少光,以及材質會把其中多少反射往攝影機。
所以,之前抽一個數字,決定要查曲線上的哪裡;現在抽一支箭頭,決定要查光從哪裡來。
這就是這裡的 。它代表一個方向,不是這條光線的亮度,也不是某個新的反射係數。
為了不要讓入射方向的下標,跟第幾個樣本的下標打架,這裡把第 個抽到的入射方向,記成 。
公式裡的表面點 ,就是剛才的地板位置 ;觀察方向 ,就是從地板指向攝影機的方向。它們先固定住,每次採樣改變的是往哪裡找入射光。
而這次每個方向要計算的東西,就不再是 ,而是「材質、入射光與照射角度」這三項相乘。我們把這個乘積縮寫成:
這裡的 ,是這個方向與表面法線的夾角。 在這一節的用途,就是替這三項乘積取個簡稱,扮演剛才「曲線高度 」的角色。
所以,原本想算的反射積分就能縮短成:
如果把它跟 放在一起看,事情其實很像:之前把整段位置的高度累積起來,現在把整個半球的方向貢獻累積起來。
2. 每抽到一個方向,就填一列資料
接著,按照方向 PDF ,獨立抽出 個方向。每個方向都算一次 ,最後平均,再加上表面自己發出的光。
先看一組示意數字。假設這塊地板不發光,所以 。我們抽了兩個方向,並且先假設已經取得各方向照過來的光;這件事實際怎麼做,下一小節再接著說。
| 要算的東西 | 第一個方向 | 第二個方向 |
|---|---|---|
| 入射輻亮度 | 10 | 0,這個方向沒有入射光 |
| 材質的 BRDF | 0.3 | 0.3 |
| 餘弦項 | 0.5 | 0.8 |
| 選定分布在這個方向的 PDF | 0.25 | 0.25 |
| 先把前三項乘起來 | ||
| 再除以 PDF |
這裡的 BRDF 數值 0.3,不是說反射了 30%;PDF 的 0.25,也不是說抽中這個精確方向的機率是 25%。它們分別是材質的方向反射函數值,以及方向的機率密度,要照表裡的方式一起使用。
所以,兩個樣本交回來的數字是 6 和 0,取平均就是 。地板自己不發光,再加上 ,這次對出射輻亮度的估計就是 3。
注意,第二個樣本雖然是 0,也要算進這兩次的平均,不能只留下成功找到光的那次。
這跟前面抽四個位置、算出四個高度再平均,操作上是不是就接起來了?而且一樣,這次算出 3,不代表真正的答案就是 3。
現在把這張表寫成一般公式,就是:
公式裡的 ,是在加總表格最後一列那些 6、0; 則是在除以樣本數,算出平均。分母的 ,就是每個方向各自查到的密度,不是所有方向都一定是示意表裡的 0.25。
如果只看一個樣本在做什麼,還是這四件事:
把這些樣本貢獻平均,再加上表面自己發出的光,就是對出射輻亮度的估計。
這裡還有一個單位問題。從地板往外看,一盞燈在視野裡占多大一片方向範圍,是用立體角來描述的;所以上面的 PDF,也是對方向的立體角定義。
但如果你是在燈的表面抽一個位置,拿到的就可能是對面積定義的 PDF。兩者不是同一個東西。例如同一盞燈移遠之後,表面面積沒有變,但從地板看過去,在視野裡占的方向範圍卻變小了。
因此,不能把面積密度直接放進這個方向積分的分母,要先轉換。這部分可以接回之前 NEE 的介紹。理想鏡面這類 delta 散射,則沿用 Dirac Delta 那篇介紹的特定方向與事件權重處理。
3. 那張表裡「照過來多少光」,到底哪來的?
但我相信大家還記得前面那個問題:
「欸,等一下。你不是說 還不知道嗎?怎麼現在寫進公式,就好像已經知道了?」
對,它沒有因為我們把公式改寫,就突然自己算出來。
上面的式子先說明:如果能取得每個抽中方向的入射光,要怎麼估計整個半球的積分。 而實際的 Path Tracing,還得沿著抽到的方向追蹤。
例如從地板沿著抽中的方向追蹤,可能發生三件事:
- 碰到燈泡:可以取得光源朝地板發出的輻亮度,拿來計算這一段的貢獻。
- 碰到牆壁:還不能只問「牆是什麼顏色」,而要繼續估計牆往地板送出多少光。在牆上再抽方向、往下追,最後把結果乘上地板這一段的權重帶回來。
- 射出場景:看那個方向有沒有環境光。有就取得環境的輻亮度,沒有就帶回 0。
所以如果路徑是「攝影機、地板、牆壁、燈泡」,我們可以先沿這個順序找到它們,再計算燈泡的光經過牆壁與地板後,對攝影機產生多少貢獻。每經過一次散射,就把那一次的材質、角度與採樣補償算進去。
這裡我們是從攝影機往場景裡找路徑,再計算光沿這些路徑傳回攝影機的貢獻。不是說現實中的光,真的從攝影機發射出去。
所以遞迴依賴並沒有消失,我們改用抽樣建立一條條路徑,估計不同反彈帶來的光照。前面介紹的 NEE,也可以在適合的交點主動找光源,再用 MIS搭配 BSDF Sampling 的結果。
那不就還是得一直反彈下去?
有這個問題。假設我們規定最多只算兩次表面散射,那需要經過第三次散射才能帶回來的光,就直接不算了。
所以實作上雖然可以設定最大反彈次數,但如果還有非零的光照貢獻被直接截掉,那估計的就是截斷後的結果;即使增加樣本,也不會自動把被省略的部分補回來。你抽一百條還是一萬條,都只允許走到第二次,當然不會突然算到第三次的光。
另一個常見工具是 Russian Roulette(俄羅斯輪盤):隨機決定是否繼續追蹤,並替存活路徑補上對應的權重。在適當條件下,這能讓路徑以機率方式結束,同時保留不偏的估計。
例如在某個節點,以 50% 的機率繼續追蹤。真的繼續時,就把後續帶回的貢獻除以 0.5,也就是算兩倍;停止時,這部分算 0。這樣才能補償「有一半機會沒有往下算」的差別,並且讓更長的路徑仍保有被追蹤到的機會。
對,才剛離開賭場,現在又多一個輪盤。這部分之後再整理,不然這篇真的沒完沒了。
八、那為什麼畫面還是那麼吵?
好,說了這麼多,蒙地卡羅好像很厲害。但實際把樣本數開低一點,畫面往往還是滿滿的 Noise。
這也很合理。回到剛才的骰子,丟 100 次得到 3.59,並沒有剛好等於 3.5。渲染時,不同像素也各自拿到不同的隨機估計;有些這次估高了,有些估低了,就形成了常見的顆粒雜訊。
所以,少量隨機樣本會讓估計不穩定,但不代表抽得不完整,就一定把答案算偏。 要看採樣有沒有漏掉貢獻、權重算得對不對,以及用的是什麼估計方法。
那一直加樣本就好了吧?
嗯,可以,但 GPU time 又要開始噴了。
這裡先分清楚兩種波動。第一種是,每一條路徑交回來的數字差多少,像剛才有的回傳 6,有的回傳 0。第二種是,每次都拿一整批路徑來平均,最後的平均值還會差多少。
例如固定每次抽 100 條路徑,渲染同一個像素。重做一次,換一批隨機樣本,就會得到另一個估計值。這些「一整批平均後的估計值」有多不穩定,就是這裡的標準誤。
所以單條路徑很不穩,跟把 100 條路徑平均之後還有多不穩,是相關但不同的兩件事。
對這篇介紹的獨立、同分布樣本平均,如果單次加權貢獻的變異數有限,也就是它的標準差不是無限大,兩者會有下面的關係:
這裡的 ,是單次加權貢獻 的標準差,描述的是前面第一種波動。左邊的 ,則是每次拿 個樣本平均之後,估計值的標準誤,描述第二種波動。
直接放數字看看。假設某個像素單次路徑貢獻的標準差是 2,每次平均 100 個獨立樣本,那估計的標準誤就是 。
改成每次平均 400 個樣本,標準誤就是 。單條路徑本身沒有變穩,我們是靠更多樣本一起平均,讓最後交回的估計比較穩。
先不用急著把符號背起來,看分母就好:想讓標準誤減半,樣本數要增加到四倍。 這也接回信賴區間那篇介紹過的 。
而且這講的是估計波動的尺度,不是保證這次渲染的實際誤差,剛好變成一半。相關推導可以看 PBRT 的 Monte Carlo Basics。
所以前幾篇那些方法,現在是不是比較接得起來了?
- 蒙地卡羅積分:用隨機樣本的加權平均,估計積分。
- 重要性採樣:調整 PDF,讓樣本多花在重要的地方,再用權重補償。
- BSDF Sampling 與 Light Sampling:利用材質或光源資訊,決定實際怎麼抽。
- MIS:替不同採樣策略的結果分配權重,讓它們互相幫忙。
它們做的事情可以接在一起。蒙地卡羅給了我們估計積分的方式,後面那些採樣與加權方法,則是在想辦法讓有限的樣本用得更有效率。
好了,介紹到這裡,終於把前幾篇一直欠著的東西補上了。
如果最後只留一句話,我會這樣說:
我們不必先把所有光路都算完,而是依照設定好的分布抽樣,計算並補償每次的貢獻,再用平均去估計答案。
至於那些隨機數到底怎麼產生、要怎麼照著 PDF 抽出樣本,那又是下一個問題了。
先挖坑,今天已經從賭場走到渲染方程式了,大家應該也累了吧。
參考資料
- Metropolis(1987):The Beginning of the Monte Carlo Method:蒙地卡羅方法的發展與命名故事。
- PBRT 第四版:Monte Carlo Basics:期望值、積分估計式、不偏性與誤差。
- PBRT 第四版:The Light Transport Equation:光照的相互依賴,以及把光傳輸改寫成路徑積分。
- PBRT 第四版:Path Tracing:逐步建立光路,以及用 Russian Roulette 處理路徑終止。
- PBRT 第四版:Improving Efficiency:重要性採樣、MIS 與提高估計效率的方法。
客官怎麼看
看完有話想說,留在這裡。罵我也可以,罵別人更好。
可用 GitHub 登入,或以筆名題字;Email 選填。地區章依網路位置辨識,臺灣可顯示縣市;編號用來區分留言。